
Vous voulez télécharger un site entier pour le consulter hors ligne, archiver une ressource ou préparer une sauvegarde avant sa disparition. Les outils gratuits existent depuis plus de 20 ans. Ils copient des milliers de pages, images et fichiers en quelques clics. Derrière la simplicité se cachent des pièges techniques, des contraintes légales et des réglages à connaître.
=> Dans la même veine : Les téléchargements après un avertissement Hadopi
Avant d’aspirer un site, vérifiez 3 points : la légalité de la copie (droit d’auteur, conditions d’utilisation), la pertinence du contenu (un blog se copie facilement, une application web dynamique beaucoup moins), et l’impact sur le serveur cible (limitez la vitesse de crawl). Les aspirateurs gratuits comme HTTrack restent la référence, mais ils ne capturent pas les contenus diffusés en streaming ni les zones protégées par un login.
Télécharger un site web complet avec des outils gratuits
Un aspirateur de site web est un logiciel qui parcourt un site et enregistre ses pages en local, images et fichiers compris. Vous obtenez une copie navigable hors ligne, sans connexion internet.
L’aspirateur conserve la mise en forme pour une lecture humaine, tandis que le scraping extrait des données brutes (prix, contacts, avis) vers un tableur. Le premier sert à archiver, le second à analyser.
Les outils du marché se rangent en trois familles. Les aspirateurs classiques (HTTrack, Wget) copient l’arborescence complète. Les extensions de navigateur enregistrent la page affichée à l’écran. Les services en ligne traitent le site à distance, sans rien installer sur votre machine.
Pour aspirer un site sans installer de logiciel, plusieurs pistes existent. L’extension SingleFile enregistre une page complète en un clic depuis Firefox ou Chrome. La commande wget --mirror fonctionne sur macOS et Linux sans dépendance graphique. Certains services en ligne acceptent une URL et vous renvoient une archive ZIP, mais leur quota gratuit reste limité.
| Outil | Type | Prix | Idéal pour |
|---|---|---|---|
| HTTrack | Logiciel | Gratuit | Copie complète hors ligne |
| Wget | Ligne de commande | Gratuit | Utilisateurs avancés |
| SingleFile | Extension | Gratuit | Archiver une page isolée |
| Octoparse | Service web | Freemium | Extraction de données |
Un aspirateur de site web, c’est un logiciel qui copie l’intégralité d’un site sur votre disque dur. Pages HTML, images, feuilles de style, scripts. La plupart des outils dont je vais vous parler sont gratuits ou proposent une version d’essai suffisante pour un usage ponctuel.
Vous connaissez déjà les méthodes rapides pour enregistrer une page, extraire des images ou capturer une vidéo. Passons aux angles que vous n’avez pas encore explorés : la sauvegarde légale, les pièges des aspirateurs, et ce qu’il faut vérifier avant de lancer un crawl complet.
La vraie question n’est pas « quel outil choisir », mais « qu’allez-vous faire de cette copie ». Un aspirateur qui télécharge 40 000 fichiers en une nuit peut saturer un petit serveur, violer les conditions d’utilisation d’un site, et remplir votre disque de contenus inutiles. Cadrez le projet avant de cliquer.
Les tests comparatifs menés en 2026 par GeekIndustry et Octoparse confirment que HTTrack reste la référence du domaine. Son statut open source et sa longévité (plus de 20 ans de développement continu) en font un choix par défaut pour une copie hors ligne fiable, sans dépendre d’un service tiers. Même les débutants s’y retrouvent, à condition d’accepter une interface qui n’a pas bougé depuis le début des années 2000.
Ce que les aspirateurs ne capturent jamais
Les outils comme HTTrack, Cyotek WebCopy ou SiteSucker excellent sur les sites statiques. Dès qu’une page repose sur du JavaScript lourd, des appels API ou une authentification, le résultat se dégrade vite. Vous récupérez le squelette HTML, mais pas les données injectées dynamiquement.
Les comparatifs récents d’Octoparse insistent sur une distinction : un aspirateur de site web classique crée une copiecomplète du site, là où un outil de web scraping ou d’IA extrait seulement les données demandées. hors ligne
Cette différence change tout dans l’usage : si votre objectif est de conserver une version navigable du site, l’aspirateur est indispensable. Si vous voulez seulement récupérer des prix, des fiches produits ou des articles précis, un scraper ciblé sera plus efficace et moins gourmand en ressources.
Concrètement, voici ce qui passe souvent à la trappe :
- Les contenus chargés après un défilement infini, type flux de réseaux sociaux.
- Les vidéos hébergées sur des plateformes externes comme YouTube, Vimeo ou Dailymotion.
- Les espaces membres, paniers d’achat et formulaires interactifs.
- Les fichiers générés à la volée par le serveur, comme les PDF dynamiques ou les exports CSV.
Un VPN, c'est un tunnel chiffré entre votre appareil et internet : votre fournisseur d'accès ne voit plus ce que vous faites, et votre adresse IP réelle reste masquée.
Concrètement, ça sert à deux choses : protéger votre vie privée, et contourner les blocages géographiques (catalogues étrangers, sites inaccessibles depuis la France). Les 2 services ci-dessous sont ceux que j'utilise et recommande, selon ce que vous cherchez.
| NordVPN | ProtonVPN | |
|---|---|---|
| Idéal pour | Streaming et débit | Vie privée et open source |
| Open source | Non | Oui |
| Offre gratuite | Essai 30 jours | Oui |
- Vous voulez surtout débloquer des catalogues étrangers et garder du débit ? Partez sur NordVPN.
- La transparence du code et une version gratuite sans carte bancaire comptent plus pour vous ? ProtonVPN est le bon choix.
Les deux offrent une garantie satisfait ou remboursé de 30 jours.
Si votre objectif est de sauvegarder un site vitrine ou un blog, vous obtiendrez un résultat fidèle. Si vous visez une application web, attendez-vous à une copie incomplète, parfois inutilisable.
La question légale avant tout téléchargement
Copier un site pour un usage personnel hors ligne reste une zone grise. La consultation hors ligne d’une page que vous auriez pu lire en ligne est généralement tolérée. La redistribution, même partielle, des contenus aspirés (textes, images, mises en page) tombe sous le coup du droit d’auteur.
Les guides pratiques comme celui d’Astuce Tech le rappellent systématiquement : l’objectif affiché de ces outils est la sauvegarde personnelle ou la consultation hors ligne, pas la reproduction à des fins commerciales. Un aspirateur utilisé pour archiver un site avant une refonte, ou pour conserver une documentation technique que vous consultez régulièrement, reste dans un cadre raisonnable. Dès que la copie sort de votre disque dur, les risques changent de nature.
Avant de lancer un crawl massif, lisez les conditions d’utilisation du site cible. Beaucoup interdisent explicitement l’aspiration automatisée. C’est le cas des sites d’actualités, des bases de données et des plateformes commerciales. Un aspirateur qui envoie des centaines de requêtes par minute peut aussi être détecté comme une attaque et entraîner un blocage de votre adresse IP.
La prudence s’impose aussi sur le choix des fichiers
Télécharger un article de presse pour le lire dans le train n’a rien à voir avec l’aspiration d’un catalogue entier de produits concurrents. Dans le second cas, vous entrez dans une logique de scraping industriel, avec des risques juridiques bien réels.
Comparer les aspirateurs gratuits les plus fiables
Les sources consultées s’accordent sur un trio de tête pour un usage personnel. Voici une synthèse de ce que chacun fait, et ne fait pas.
Les tests de GeekIndustry confirment que HTTrack coche toutes les cases pour un utilisateur qui débute : gratuit, open source, et suffisamment guidé pour ne pas se perdre dans les réglages. Son principal défaut reste une interface qui semble figée dans le temps, mais cette austérité cache une stabilité rare. Les utilisateurs avancés apprécient la reprise des téléchargements interrompus, une fonctionnalité qui sauve des nuits de travail quand un crawl de 30 000 pages s’arrête à mi-chemin.
| Outil | Plateforme | Points forts | Limites |
|---|---|---|---|
| HTTrack | Windows, Linux, Android | Gratuit, open source, très complet, reprend les téléchargements interrompus | Interface datée, courbe d’apprentissage, lent sur les très gros sites |
| Cyotek WebCopy | Windows | Plus convivial que HTTrack, bonne gestion des liens internes | Moins de documentation française, pas de version macOS |
| SiteSucker | macOS, iOS | Simple, natif Apple, pause et reprise des téléchargements | Payant (5 euros), options avancées limitées |
Si vous débutez et que vous êtes sur Windows, HTTrack reste le choix le plus sûr. Il est gratuit, maintenu depuis plus de 20 ans, et la communauté francophone est active. Si vous cherchez la simplicité sur Mac, SiteSucker fait le travail sans prise de tête, pour le prix d’un café.
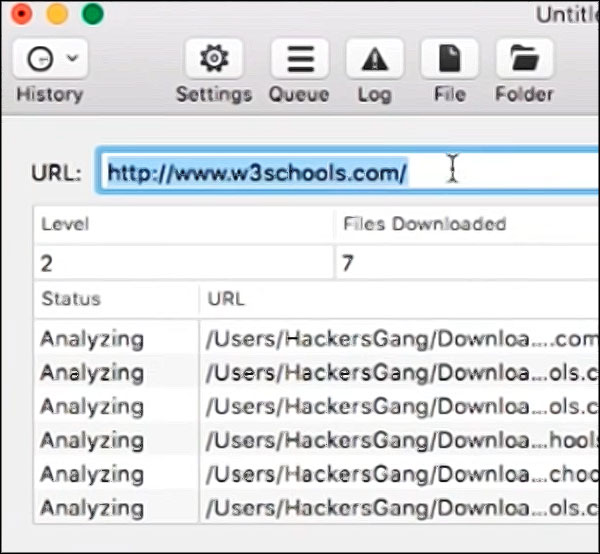
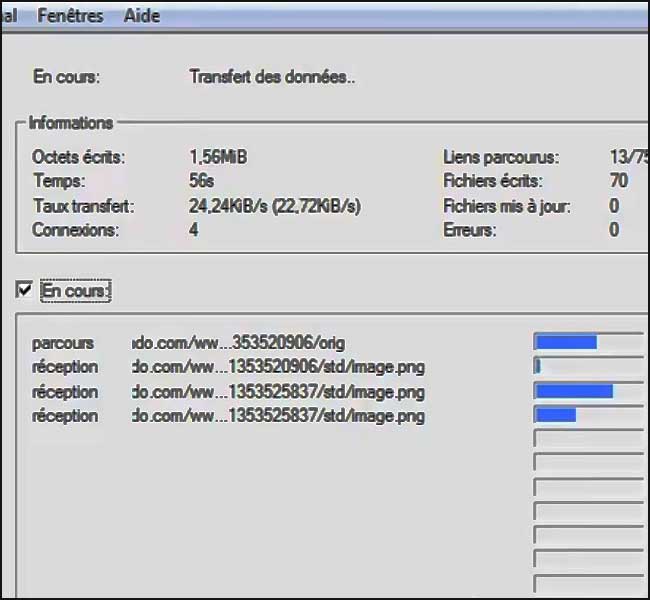
HTTrack est sans doute le logiciel le plus populaire et c’est un logiciel libre et gratuit permettant de télécharger un site web en entier pour une consultation hors ligne.
Configurer un crawl propre et respectueux
Un aspirateur bien réglé ne se remarque pas. Un aspirateur mal configuré sature le serveur cible, déclenche des alertes de sécurité et finit par se faire bloquer. Trois réglages font la différence.
Les documentations de Cyotek WebCopy insistent sur un point que les débutants négligent : la gestion des liens internes. Par défaut, l’outil suit tous les liens qu’il trouve, y compris ceux qui pointent vers des domaines externes. Sans filtre, vous pouvez vous retrouver à aspirer un réseau entier de sites liés, avec des volumes de données qui explosent en quelques heures. Un bon réglage initial consiste à limiter le crawl au domaine principal et à ses sous-domaines directs.
Limiter la vitesse et la profondeur
Vous savez déjà lequel vous correspond ? Accès direct :
HTTrack et Cyotek WebCopy permettent de définir un délai entre chaque requête. Une seconde minimum est raisonnable. Réduisez aussi la profondeur de crawl : inutile de suivre les liens vers des domaines externes, sauf si vous voulez aspirer tout un écosystème de sites liés.
Sur un site moyen de quelques centaines de pages, un délai d’une seconde entre les requêtes donne un crawl qui dure entre 30 minutes et une heure. C’est lent, mais c’est précisément ce qui distingue une sauvegarde respectueuse d’une attaque automatisée. Les serveurs modernes détectent les rafales de requêtes et bloquent les adresses IP qui dépassent un certain seuil. Mieux vaut passer une nuit sur un crawl que de se faire bannir définitivement du site que vous vouliez sauvegarder.
Filtrer les types de fichiers
Par défaut, un aspirateur télécharge tout : images, scripts, feuilles de style, PDF. Si vous ne voulez que les textes, excluez les extensions inutiles. Vous éviterez de remplir votre disque avec des fichiers que vous ne lirez jamais, et vous réduirez la charge sur le serveur cible.
Les utilisateurs de Cyotek WebCopy apprécient particulièrement la possibilité de définir des règles d’inclusion et d’exclusion par type de fichier. Vous pouvez, par exemple, conserver uniquement les pages HTML et les images, tout en excluant les scripts JavaScript et les feuilles de style. La copie reste navigable, mais elle perd quelques fonctionnalités cosmétiques. Pour une sauvegarde de lecture, c’est souvent un compromis acceptable.
Respecter le fichier robots.txt
Le fichier robots.txt indique aux robots d’exploration les zones interdites. Les aspirateurs sérieux le respectent par défaut. Ne le désactivez pas par curiosité : c’est la première ligne de défense des webmasters, et la première preuve de votre bonne foi en cas de litige.
Les aspirateurs gratuits comme HTTrack et Cyotek WebCopy intègrent nativement la lecture du robots.txt. Ce fichier, placé à la racine du site, liste les répertoires que les robots ne doivent pas explorer. Le respecter, c’est s’assurer que votre crawl reste dans les clous, même si le site cible n’a pas explicitement interdit l’aspiration dans ses conditions d’utilisation. C’est un réflexe de bonne conduite qui coûte zéro effort et évite beaucoup d’ennuis.
Pourquoi j’évite les aspirateurs en ligne
Des services web promettent d’aspirer un site sans rien installer : vous collez une URL, ils vous renvoient un fichier zip. C’est tentant, et c’est souvent une mauvaise idée. Vous confiez votre adresse IP, votre historique de navigation et parfois votre email à un intermédiaire opaque, pour un résultat généralement moins bon qu’un outil de bureau.
Les tests d’Astuce Tech le confirment : les aspirateurs en ligne imposent presque tous des limites sévères en version gratuite. Nombre de pages, taille des fichiers, délai d’attente, au-delà, il faut payer. Et rien ne garantit que le service ne conserve pas une copie des sites que vous aspirez. Pour un usage ponctuel et privé, un logiciel de bureau reste plus sûr et plus complet.
Un autre angle mort des services en ligne : la confidentialité des données aspirées. Si vous sauvegardez un site contenant des informations personnelles ou professionnelles sensibles, les confier à un tiers est un risque inutile. Un logiciel de bureau comme HTTrack garde tout en local, sans jamais envoyer la moindre information sur vos habitudes de navigation à un serveur distant.
Que faire de votre copie une fois téléchargée
Une copie aspirée n’est utile que si vous savez la retrouver et la lire. Quelques réflexes simples évitent de se retrouver avec un dossier de 12 Go impossible à naviguer.
Les utilisateurs réguliers d’aspirateurs recommandent une organisation systématique : un dossier par site, avec la date de téléchargement dans le nom. Cette habitude devient précieuse quand vous aspirez plusieurs versions d’un même site à des moments différents. Vous pouvez comparer les évolutions, retrouver une version antérieure d’une page supprimée, ou simplement savoir quelle copie est la plus récente.
- Rangez chaque site dans un dossier dédié, avec la date de téléchargement dans le nom.
- Ouvrez la copie avec un navigateur en mode hors ligne pour vérifier que la navigation interne fonctionne.
- Supprimez les fichiers inutiles, comme les scripts de suivi, les publicités ou les images décoratives.
- Conservez le fichier de projet de l’aspirateur si vous prévoyez une mise à jour incrémentale.
Questions fréquentes
Peut-on aspirer un site web avec l’intelligence artificielle ?
Oui, depuis 2024 plusieurs outils combinent IA et crawling. Vous décrivez en langage naturel les pages à récupérer, l’IA identifie les sélecteurs CSS et lance la copie. Le gain de temps est réel sur les sites complexes, mais le résultat reste à vérifier manuellement.
Un aspirateur de site peut-il télécharger une vidéo YouTube intégrée ?
Non. Les aspirateurs classiques copient les fichiers hébergés sur le domaine cible. Une vidéo YouTube est chargée depuis les serveurs de YouTube, pas depuis le site qui l’intègre. Pour ce type de contenu, il faut un outil dédié au téléchargement de vidéos en streaming.
Est-il légal d’aspirer un site pour le consulter hors ligne ?
Pour un usage strictement personnel, la consultation hors ligne d’une page accessible publiquement est généralement tolérée. La redistribution des contenus aspirés, même partielle, enfreint le droit d’auteur. Vérifiez toujours les conditions d’utilisation du site cible avant un crawl massif.
Combien de temps faut-il pour aspirer un site moyen ?
Tout dépend de la taille du site et de la vitesse de crawl configurée. Un blog de quelques centaines de pages peut prendre moins d’une heure avec une connexion correcte. Un site de plusieurs milliers de pages, avec un délai d’une seconde entre les requêtes, peut demander plusieurs heures, voire une nuit complète.
Le bon réflexe n’est pas de télécharger plus, mais de télécharger mieux. Un aspirateur bien configuré vous donne une copie fidèle, légale et consultable. Un crawl sauvage vous apporte un dossier illisible et des ennuis potentiels. La différence tient en trois réglages : vitesse, profondeur, filtres.
Pour aller plus loin, NordVPN reste l’option que je recommande pour ce genre de situation.
Article utile ? Dites-le à Google. Ajoutez ce blog à vos sources préférées : un clic, et vous le retrouverez dans vos recherches (et l’AI Mode) au lieu du contenu recyclé par des robots. C’est votre façon de reprendre le contrôle sur ce que vous lisez.
Et si vous avez aimé, partagez (c’est le meilleur coup de pouce pour un blog indépendant qui publie sans algorithme ni sponsor déguisé).
Un clic, gratuit. Nécessite d’être connecté à votre compte Google.
lol dude you probably downloaded the whole internet with that tool. If ur settings are wrong it just keeps following every redirect and loops forever, jumping from server to server, it never ends lol
C’est plus simple en ligne de commande :
exemple :
wget -e robots=off -m -r -l 10 -U « Mozilla/440.0 » https://forumamontres.forumactif.com/
L’autre point fort de ScrapingBee est la gestion des proxy. De nombreux sites Web limitent le nombre d’adresses IP sur leurs pages. Disons qu’un site Web autorise 10 requêtes par jour et par adresse IP. Si vous devez effectuer 100 000 requêtes en une seule journée, vous aurez besoin de 10 000 proxys uniques. C’est beaucoup. En général, les fournisseurs de proxy facturent environ un à trois dollars par adresse IP unique et par mois. La facture peut exploser très rapidement.
WebAutomation vous aide à extraire des données instantanément de n’importe quel site Web en quelques minutes, sans codage, grâce à des extracteurs prêts à l’emploi.
Cet extracteur en un clic vous permet d’extraire instantanément des données de plus de 400 sites Web populaires tels que Amazon, Google Maps, eBay, Airbnb, Yelp et bien d’autres !
Le web scraping est une compétence utilisée pour extraire des données de sites web. Ces données peuvent être utilisées pour des études de marché, des comparaisons de prix, des projets de science des données, et plus encore. Il s’agit sans aucun doute de l’une des compétences importantes que vous devez maîtriser en tant que data scientist.
Scraper API est conçu pour simplifier le scraping web. Cet outil proxy API est capable de gérer des proxys, des navigateurs Web et des CAPTCHAs.
Il prend en charge les langages de programmation populaires tels que Bash, Node, Python, Ruby, Java et PHP.
ParseHub est un puissant outil de scraping web qui vous aide à extraire des données en cliquant sur les données dont vous avez besoin.
Pour ce faire, vous devez d’abord télécharger son application de bureau. Une fois l’application installée, ouvrez-la et choisissez un site sur lequel vous souhaitez extraire des données. Cliquez ensuite sur les données cibles pour les extraire. Après cela, les données seront collectées par leurs serveurs et téléchargées dans un format JSON, Excel, API, ou tout autre format que vous avez choisi.
Parmi les fonctions avancées que vous pouvez réaliser avec Parsehub, citons l’obtention de données à partir de plusieurs pages, l’interaction avec AJAX, les formulaires, les listes déroulantes, etc.
HipSocial vous permet de gratter le web pour trouver du contenu intéressant afin de le publier facilement sur les réseaux sociaux. Vous pouvez extraire des données de sites ciblés et les publier directement à partir de l’outil sur des plateformes de réseaux sociaux populaires intégrées.
L’outil comprend NinjaSEO Bot – une extension Chrome bot – qui vous permet d’extraire de grands volumes de données sans aucune programmation. Outre le contenu textuel, vous pouvez récupérer des images pertinentes pour votre marque ou celle de votre client.
HipSocial offre également une fonction d’écoute sociale pour mesurer la performance de vos activités de communication sur les réseaux sociaux ainsi qu’un outil d’analyse des médias sociaux pour évaluer ce qui intéresse vos followers.
HipSocial offre un « prix unique pour 50 applications » à partir de 14,99 $ / mois (cloud) à 74,95 $ / mois (entreprise).
L’extraction de données de sites Web implique généralement l’apprentissage d’un langage de programmation comme Python et de bibliothèques telles que Selenium ou Scrapy ; cependant, même les personnes qui ne savent pas coder peuvent extraire des sites Web.
Apify vous permet aussi de transformer n’importe quel site Web en une API. Il peut vous aider à effectuer du web scraping, de l’automatisation web (automatisation des flux de travail manuels sur le web, comme le remplissage de formulaires ou le téléchargement de fichiers) et de l’intégration web (connexion de divers services web et API).
Parmi les produits sympas qu’il propose, citons actors (plateforme informatique qui facilite le développement, l’exécution et le partage de programmes en nuage sans serveur) et proxy (cache l’origine de vos racleurs Web). En outre, comme les autres outils cités, vous pouvez exporter les données extraites vers des formats tels que CSV, Excel ou JSON.
Les extensions de navigateur Web peuvent constituer un moyen efficace d’extraire des données d’un site Web. L’idéal est d’extraire des données bien formées, par exemple un tableau ou une liste d’éléments sur une page. Certaines extensions, comme DataMiner, proposent des recettes de scraping prêtes à l’emploi pour des sites Web populaires comme Amazon, Ebay, etc.
Les outils de scraping Web sont spécifiquement développés pour extraire des informations des sites Web. Ils sont également connus sous le nom d’outils de récolte Web ou d’outils d’extraction de données Web.
Ces outils sont utiles à toute personne qui tente de collecter des données sous une forme ou une autre à partir d’Internet. Le Web Scraping est la nouvelle technique de saisie de données qui ne nécessite pas de saisie répétitive ou de copier-coller.
Octoparse rend le scraping web facile pour tout le monde. Vous pouvez rapidement extraire des données Web sans coder. Il vous suffit de pointer, de cliquer et d’extraire !
Cet outil divise l’ensemble du processus de scraping en trois étapes. Tout d’abord, vous devez saisir l’URL du site Web dont vous souhaitez extraire des données. Ensuite, vous devez cliquer sur les données cibles que vous souhaitez extraire.
Enfin, il suffit de lancer l’extraction et, en quelques minutes, les données seront prêtes à être utilisées. Les données que vous extrayez peuvent être stockées dans un fichier CSV, Excel, API ou une base de données. Choisissez l’option qui vous convient le mieux.
Les outils de raclage de sites Web peuvent vous aider à vous tenir au courant de l’évolution de votre entreprise ou de votre secteur d’activité au cours des six prochains mois, ce qui constitue un outil puissant pour les études de marché.
Ces outils peuvent récupérer des données auprès de plusieurs fournisseurs d’analyses de données et de sociétés d’études de marché et les regrouper en un seul endroit pour faciliter la consultation et l’analyse.
Les outils de scraping Web comme ScreamingFrog ou ScrapeBox sont parfaits pour extraire des données du Web, et de Google en particulier. Selon votre cas d’utilisation, comme le SEO, la recherche de mots-clés ou la recherche de liens brisés, c’est peut-être la chose la plus facile à utiliser.
D’autres logiciels comme ParseHub sont également très utiles pour les personnes qui n’ont pas de connaissances en codage. Il s’agit d’applications de bureau qui permettent d’extraire facilement des données du Web. Vous créez des instructions sur l’application, comme la sélection de l’élément dont vous avez besoin, le défilement, etc.
Ces outils peuvent également être utilisés pour extraire des données telles que les emails et les numéros de téléphone de divers sites web, ce qui permet de disposer d’une liste de fournisseurs, de fabricants et d’autres personnes présentant un intérêt pour votre activité ou votre entreprise, ainsi que de leurs adresses de contact respectives.
Zyte (anciennement Scrapinghub) est un outil d’extraction de données basé sur le cloud qui aide des milliers de développeurs à récupérer des données précieuses. Zyte utilise Crawlera, un rotateur de proxy intelligent qui permet de contourner les contre-mesures des robots pour explorer facilement des sites volumineux ou protégés par des robots.
Zyte convertit la page Web entière en contenu organisé (25 euros par mois).
ParseHub est conçu pour explorer un ou plusieurs sites Web et prend en charge JavaScript, AJAX, les sessions, les cookies et les redirections. L’application utilise une technologie d’apprentissage automatique pour reconnaître les documents les plus compliqués sur le web et génère le fichier de sortie en fonction du format de données requis.
ParseHub, outre l’application web, est également disponible en tant qu’application de bureau gratuite pour Windows, macOS et Linux qui propose un plan gratuit de base couvrant cinq projets de crawl. Ce service propose un plan premium pour 89 dollars par mois avec une prise en charge de 20 projets et 10 000 pages web par crawl.
À l’aide d’un outil de scraping web, on peut également télécharger des solutions pour une lecture ou un stockage hors ligne en collectant des données sur plusieurs sites (notamment StackOverflow et d’autres sites de questions-réponses).
Cela réduit la dépendance à l’égard des connexions Internet actives, car les ressources sont facilement accessibles malgré la disponibilité d’un accès internet.
Ces outils permettent également d’extraire sans effort des données sur la base de différents filtres appliqués et de récupérer des données de manière efficace sans recherche manuelle.
ScrapingBot est une excellente API de scraping web pour les développeurs web qui ont besoin de récupérer des données à partir d’une URL. Elle fonctionne particulièrement bien sur les pages de produits où elle collecte tout ce dont vous avez besoin (image, titre du produit, prix du produit, description du produit, stock, frais de livraison, etc…). C’est un excellent outil pour ceux qui ont besoin de collecter des données commerciales ou simplement d’agréger des données de produits et de les garder exactes.
ScrapingBot propose également diverses API spécialisées telles que l’immobilier, les résultats de recherche Google ou la collecte de données sur les réseaux sociaux (LinkedIn, TikTok, Instagram, Facebook, Twitter).
Scraper est une extension Chrome dont les fonctionnalités d’extraction de données sont limitées, mais qui permet d’effectuer des recherches sur internet et d’exporter des données vers des tableurs Google. Cet outil est destiné aux débutants et aux experts qui peuvent facilement copier des données dans le presse-papiers ou les stocker dans des feuilles de calcul en utilisant OAuth.
Scraper est un outil gratuit qui fonctionne directement dans votre navigateur et génère automatiquement de petits XPaths pour définir les URL à explorer. Il ne vous offre pas la facilité du crawling automatique ou robotisé comme Import, Webhose et d’autres, mais c’est aussi un avantage pour les novices car vous n’avez pas besoin de vous attaquer à une configuration compliquée.
Le scraping des pages de résultats de recherche de Google peut être un véritable casse-tête sans la configuration adéquate. L’API SERP de Smartproxy est une excellente solution pour cela. Cette API SERP combine un énorme réseau de proxy, un scraper Web et un analyseur de données.
Il s’agit d’une solution complète qui vous permet d’obtenir des données structurées à partir des principaux moteurs de recherche en envoyant une seule demande d’API réussie à 100 %.
Vous pouvez cibler n’importe quel pays, état ou ville et obtenir des résultats bruts en HTML ou des résultats analysés en JSON. Qu’il s’agisse de vérifier le classement des mots clés et de localiser d’autres paramètres de SEO en temps réel, de récupérer des données payantes et organiques ou de surveiller les prix, les proxys de moteurs de recherche de Smartproxy couvrent tout.
Le web est en train de devenir une incroyable source de données. Il y a de plus en plus de données disponibles en ligne, qu’il s’agisse de contenu généré par les utilisateurs sur les réseaux sociaux et les forums, de sites de commerce électronique, de sites immobiliers ou de médias… De nombreuses entreprises sont construites sur ces données web, ou en dépendent fortement.
Extraire manuellement des données d’un site web et les copier/coller dans une feuille de calcul est un processus long et sujet aux erreurs. Si vous devez extraire des millions de pages, il n’est pas possible de le faire manuellement, vous devez donc l’automatiser.
Bonjour, je cherche à faire un truc différent de ce qui est énoncé au-dessus. Une page web avec un champ de formulaire, renvoi une liste de résultat suivant ce qu’on a mis dans le champ (un code postal). Est-il possible de récupérer l’ensemble des résultats possibles en rejouant le même scenario pour une liste de codes postaux.
C’est une base de données publique qui n’est pas téléchargeables (sur ce que j’ai pu avoir comme information jusqu’à maintenant…) et qui ne propose pas non plus d’API.
Scrapy est un framework open source de scraping web en python. À notre avis, il s’agit d’un excellent point de départ pour extraire des données structurées de sites Web à grande échelle. Il résout de nombreux problèmes courants de manière très élégante :
– Concurrence (Scraping de plusieurs pages en même temps)
– Auto-throttling, afin d’éviter de perturber les sites Web tiers dont vous extrayez les données.
– Format d’exportation flexible, CSV, JSON, XML et backend pour le stockage (Amazon S3, FTP, Google cloud…)
– Rampement automatique
– Pipeline média intégré pour télécharger les images et les ressources
ScrapingBee peut vous aider à la fois avec la gestion du proxy et les navigateurs sans tête. C’est une excellente solution lorsque vous ne voulez pas vous occuper de l’un ou l’autre.
L’utilisation de navigateurs sans tête en production pose de nombreux problèmes. Il est facile d’exécuter une instance de Selenium ou de Puppeteer sur votre ordinateur portable, mais en exécuter des dizaines en production relève d’un autre domaine. Tout d’abord, vous avez besoin de serveurs puissants. Headless Chrome, par exemple, nécessite au moins 1 Go de mémoire vive et un cœur de processeur pour fonctionner correctement.
Si vous avez besoin d’une grande quantité de données provenant du Web pour un cas d’utilisation spécifique, vous pouvez vérifier que l’ensemble de données n’existe pas déjà. Par exemple, disons que vous voulez la liste de tous les sites Web dans le monde utilisant une technologie particulière comme Shopify. Ce serait une tâche énorme que de parcourir l’ensemble du Web ou un annuaire (si un tel annuaire existe) pour obtenir cette liste. Vous pouvez facilement obtenir cette liste en l’achetant à des courtiers en données comme builtwith.com.
Sitechcker propose un robot d’exploration de sites Web basé sur le cloud qui explore votre site en temps réel et fournit une analyse SEO technique. En moyenne, l’outil parcourt jusqu’à 300 pages en 2 minutes, en analysant tous les liens internes et externes, et vous fournit un rapport complet directement sur votre tableau de bord.
Vous pouvez personnaliser les règles et les filtres de l’outil d’exploration à l’aide de paramètres flexibles, en fonction de vos besoins, et obtenir un score fiable qui vous renseigne sur la santé de votre site.
De même, vous serez informé par email de tous les problèmes survenant sur votre site, et vous pourrez également collaborer avec les membres de votre équipe et les entrepreneurs en envoyant un lien partageable vers le projet.
L’objectif de WebScraper est de rendre l’extraction de données web aussi simple que possible. Contrairement à d’autres outils, il s’agit d’une extension disponible sur Chrome et Firefox. Vous pouvez configurer un scraper en pointant et en cliquant simplement sur des éléments.
WebScraper vous permet également d’extraire des données de sites Web dynamiques. Il peut extraire des données de sites comportant plusieurs niveaux de navigation et parcourir un site Web à tous les niveaux (catégories et sous-catégories, pagination, pages de produits). Les données peuvent être exportées vers les formats CSV, XLSX et JSON, et même vers Dropbox.
Import.io offre un constructeur pour former vos propres ensembles de données en important simplement les données d’une page web particulière et en exportant les données vers CSV. Vous pouvez facilement gratter des milliers de pages Web en quelques minutes sans écrire une seule ligne de code et construire plus de 1000 API en fonction de vos besoins.
Import.io utilise une technologie de pointe pour récupérer des millions de données chaque jour, que les entreprises peuvent utiliser pour une somme modique. En plus de l’outil web, il offre également des applications gratuites pour Windows, macOS et Linux pour construire des extracteurs de données et des crawlers, télécharger des données et se synchroniser avec le compte internet.