Vous voulez télécharger un site entier pour le consulter hors ligne, archiver une ressource ou préparer une sauvegarde avant sa disparition. Les outils gratuits existent depuis plus de 20 ans. Ils copient des milliers de pages, images et fichiers en quelques clics. Derrière la simplicité se cachent des pièges techniques, des contraintes légales et des réglages à connaître.
=> Dans la même veine : Les téléchargements après un avertissement Hadopi
Avant d’aspirer un site, vérifiez 3 points : la légalité de la copie (droit d’auteur, conditions d’utilisation), la pertinence du contenu (un blog se copie facilement, une application web dynamique beaucoup moins), et l’impact sur le serveur cible (limitez la vitesse de crawl). Les aspirateurs gratuits comme HTTrack restent la référence, mais ils ne capturent pas les contenus diffusés en streaming ni les zones protégées par un login.
Télécharger un site web complet avec des outils gratuits
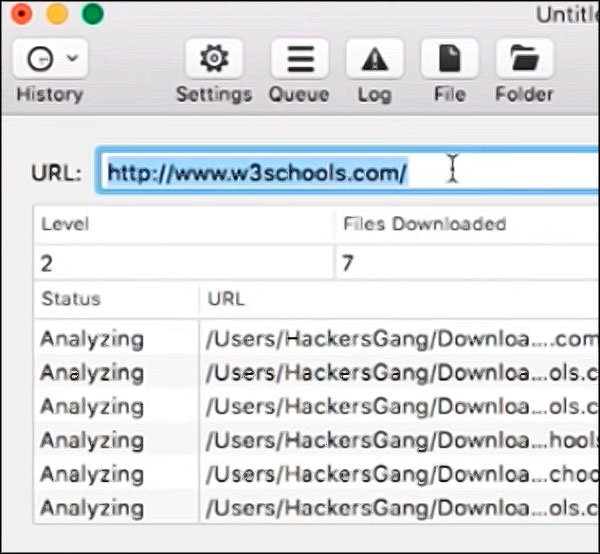
Un aspirateur de site web est un logiciel qui parcourt un site et enregistre ses pages en local, images et fichiers compris. Vous obtenez une copie navigable hors ligne, sans connexion internet.
L’aspirateur conserve la mise en forme pour une lecture humaine, tandis que le scraping extrait des données brutes (prix, contacts, avis) vers un tableur. Le premier sert à archiver, le second à analyser.
Les outils du marché se rangent en trois familles. Les aspirateurs classiques (HTTrack, Wget) copient l’arborescence complète. Les extensions de navigateur enregistrent la page affichée à l’écran. Les services en ligne traitent le site à distance, sans rien installer sur votre machine.
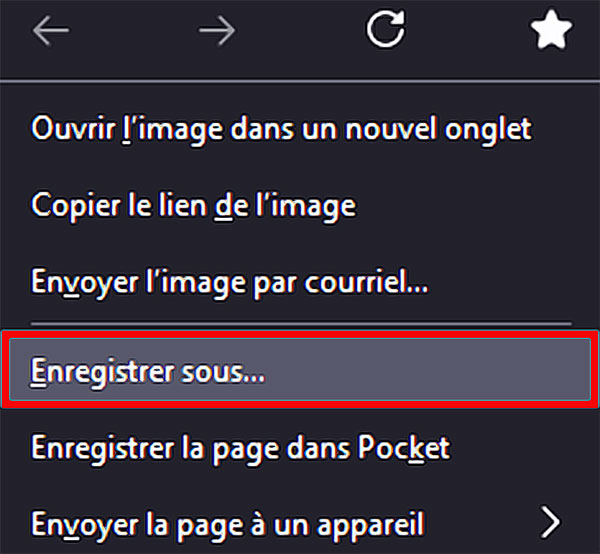
Pour aspirer un site sans installer de logiciel, plusieurs pistes existent. L’extension SingleFile enregistre une page complète en un clic depuis Firefox ou Chrome. La commande wget --mirror fonctionne sur macOS et Linux sans dépendance graphique. Certains services en ligne acceptent une URL et vous renvoient une archive ZIP, mais leur quota gratuit reste limité.
| Outil | Type | Prix | Idéal pour |
|---|---|---|---|
| HTTrack | Logiciel | Gratuit | Copie complète hors ligne |
| Wget | Ligne de commande | Gratuit | Utilisateurs avancés |
| SingleFile | Extension | Gratuit | Archiver une page isolée |
| Octoparse | Service web | Freemium | Extraction de données |
Un aspirateur de site web, c’est un logiciel qui copie l’intégralité d’un site sur votre disque dur. Pages HTML, images, feuilles de style, scripts. La plupart des outils dont je vais vous parler sont gratuits ou proposent une version d’essai suffisante pour un usage ponctuel.
Vous connaissez déjà les méthodes rapides pour enregistrer une page, extraire des images ou capturer une vidéo. Passons aux angles que vous n’avez pas encore explorés : la sauvegarde légale, les pièges des aspirateurs, et ce qu’il faut vérifier avant de lancer un crawl complet.
La vraie question n’est pas « quel outil choisir », mais « qu’allez-vous faire de cette copie ». Un aspirateur qui télécharge 40 000 fichiers en une nuit peut saturer un petit serveur, violer les conditions d’utilisation d’un site, et remplir votre disque de contenus inutiles. Cadrez le projet avant de cliquer.
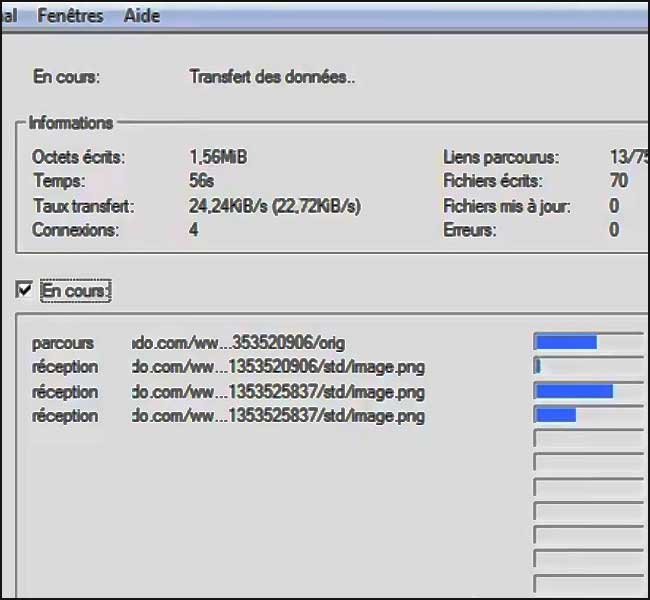
Les tests comparatifs menés en 2026 par GeekIndustry et Octoparse confirment que HTTrack reste la référence du domaine. Son statut open source et sa longévité (plus de 20 ans de développement continu) en font un choix par défaut pour une copie hors ligne fiable, sans dépendre d’un service tiers. Même les débutants s’y retrouvent, à condition d’accepter une interface qui n’a pas bougé depuis le début des années 2000.
Ce que les aspirateurs ne capturent jamais
Les outils comme HTTrack, Cyotek WebCopy ou SiteSucker excellent sur les sites statiques. Dès qu’une page repose sur du JavaScript lourd, des appels API ou une authentification, le résultat se dégrade vite. Vous récupérez le squelette HTML, mais pas les données injectées dynamiquement.
Les comparatifs récents d’Octoparse insistent sur une distinction : un aspirateur de site web classique crée une copiecomplète du site, là où un outil de web scraping ou d’IA extrait seulement les données demandées. hors ligne
Cette différence change tout dans l’usage : si votre objectif est de conserver une version navigable du site, l’aspirateur est indispensable. Si vous voulez seulement récupérer des prix, des fiches produits ou des articles précis, un scraper ciblé sera plus efficace et moins gourmand en ressources.
Concrètement, voici ce qui passe souvent à la trappe :
- Les contenus chargés après un défilement infini, type flux de réseaux sociaux.
- Les vidéos hébergées sur des plateformes externes comme YouTube, Vimeo ou Dailymotion.
- Les espaces membres, paniers d’achat et formulaires interactifs.
- Les fichiers générés à la volée par le serveur, comme les PDF dynamiques ou les exports CSV.
Si votre objectif est de sauvegarder un site vitrine ou un blog, vous obtiendrez un résultat fidèle. Si vous visez une application web, attendez-vous à une copie incomplète, parfois inutilisable.
La question légale avant tout téléchargement
Copier un site pour un usage personnel hors ligne reste une zone grise. La consultation hors ligne d’une page que vous auriez pu lire en ligne est généralement tolérée. La redistribution, même partielle, des contenus aspirés (textes, images, mises en page) tombe sous le coup du droit d’auteur.
Les guides pratiques comme celui d’Astuce Tech le rappellent systématiquement : l’objectif affiché de ces outils est la sauvegarde personnelle ou la consultation hors ligne, pas la reproduction à des fins commerciales. Un aspirateur utilisé pour archiver un site avant une refonte, ou pour conserver une documentation technique que vous consultez régulièrement, reste dans un cadre raisonnable. Dès que la copie sort de votre disque dur, les risques changent de nature.
Avant de lancer un crawl massif, lisez les conditions d’utilisation du site cible. Beaucoup interdisent explicitement l’aspiration automatisée. C’est le cas des sites d’actualités, des bases de données et des plateformes commerciales. Un aspirateur qui envoie des centaines de requêtes par minute peut aussi être détecté comme une attaque et entraîner un blocage de votre adresse IP.
La prudence s’impose aussi sur le choix des fichiers
Télécharger un article de presse pour le lire dans le train n’a rien à voir avec l’aspiration d’un catalogue entier de produits concurrents. Dans le second cas, vous entrez dans une logique de scraping industriel, avec des risques juridiques bien réels.
Comparer les aspirateurs gratuits les plus fiables
Les sources consultées s’accordent sur un trio de tête pour un usage personnel. Voici une synthèse de ce que chacun fait, et ne fait pas.
Les tests de GeekIndustry confirment que HTTrack coche toutes les cases pour un utilisateur qui débute : gratuit, open source, et suffisamment guidé pour ne pas se perdre dans les réglages. Son principal défaut reste une interface qui semble figée dans le temps, mais cette austérité cache une stabilité rare. Les utilisateurs avancés apprécient la reprise des téléchargements interrompus, une fonctionnalité qui sauve des nuits de travail quand un crawl de 30 000 pages s’arrête à mi-chemin.
| Outil | Plateforme | Points forts | Limites |
|---|---|---|---|
| HTTrack | Windows, Linux, Android | Gratuit, open source, très complet, reprend les téléchargements interrompus | Interface datée, courbe d’apprentissage, lent sur les très gros sites |
| Cyotek WebCopy | Windows | Plus convivial que HTTrack, bonne gestion des liens internes | Moins de documentation française, pas de version macOS |
| SiteSucker | macOS, iOS | Simple, natif Apple, pause et reprise des téléchargements | Payant (5 euros), options avancées limitées |
Si vous débutez et que vous êtes sur Windows, HTTrack reste le choix le plus sûr. Il est gratuit, maintenu depuis plus de 20 ans, et la communauté francophone est active. Si vous cherchez la simplicité sur Mac, SiteSucker fait le travail sans prise de tête, pour le prix d’un café.
HTTrack est sans doute le logiciel le plus populaire et c’est un logiciel libre et gratuit permettant de télécharger un site web en entier pour une consultation hors ligne.
Configurer un crawl propre et respectueux
Un aspirateur bien réglé ne se remarque pas. Un aspirateur mal configuré sature le serveur cible, déclenche des alertes de sécurité et finit par se faire bloquer. Trois réglages font la différence.
Les documentations de Cyotek WebCopy insistent sur un point que les débutants négligent : la gestion des liens internes. Par défaut, l’outil suit tous les liens qu’il trouve, y compris ceux qui pointent vers des domaines externes. Sans filtre, vous pouvez vous retrouver à aspirer un réseau entier de sites liés, avec des volumes de données qui explosent en quelques heures. Un bon réglage initial consiste à limiter le crawl au domaine principal et à ses sous-domaines directs.
Limiter la vitesse et la profondeur
HTTrack et Cyotek WebCopy permettent de définir un délai entre chaque requête. Une seconde minimum est raisonnable. Réduisez aussi la profondeur de crawl : inutile de suivre les liens vers des domaines externes, sauf si vous voulez aspirer tout un écosystème de sites liés.
Sur un site moyen de quelques centaines de pages, un délai d’une seconde entre les requêtes donne un crawl qui dure entre 30 minutes et une heure. C’est lent, mais c’est précisément ce qui distingue une sauvegarde respectueuse d’une attaque automatisée. Les serveurs modernes détectent les rafales de requêtes et bloquent les adresses IP qui dépassent un certain seuil. Mieux vaut passer une nuit sur un crawl que de se faire bannir définitivement du site que vous vouliez sauvegarder.
Filtrer les types de fichiers
Par défaut, un aspirateur télécharge tout : images, scripts, feuilles de style, PDF. Si vous ne voulez que les textes, excluez les extensions inutiles. Vous éviterez de remplir votre disque avec des fichiers que vous ne lirez jamais, et vous réduirez la charge sur le serveur cible.
Les utilisateurs de Cyotek WebCopy apprécient particulièrement la possibilité de définir des règles d’inclusion et d’exclusion par type de fichier. Vous pouvez, par exemple, conserver uniquement les pages HTML et les images, tout en excluant les scripts JavaScript et les feuilles de style. La copie reste navigable, mais elle perd quelques fonctionnalités cosmétiques. Pour une sauvegarde de lecture, c’est souvent un compromis acceptable.
Respecter le fichier robots.txt
Le fichier robots.txt indique aux robots d’exploration les zones interdites. Les aspirateurs sérieux le respectent par défaut. Ne le désactivez pas par curiosité : c’est la première ligne de défense des webmasters, et la première preuve de votre bonne foi en cas de litige.
Les aspirateurs gratuits comme HTTrack et Cyotek WebCopy intègrent nativement la lecture du robots.txt. Ce fichier, placé à la racine du site, liste les répertoires que les robots ne doivent pas explorer. Le respecter, c’est s’assurer que votre crawl reste dans les clous, même si le site cible n’a pas explicitement interdit l’aspiration dans ses conditions d’utilisation. C’est un réflexe de bonne conduite qui coûte zéro effort et évite beaucoup d’ennuis.
Pourquoi j’évite les aspirateurs en ligne
Des services web promettent d’aspirer un site sans rien installer : vous collez une URL, ils vous renvoient un fichier zip. C’est tentant, et c’est souvent une mauvaise idée. Vous confiez votre adresse IP, votre historique de navigation et parfois votre email à un intermédiaire opaque, pour un résultat généralement moins bon qu’un outil de bureau.
Les tests d’Astuce Tech le confirment : les aspirateurs en ligne imposent presque tous des limites sévères en version gratuite. Nombre de pages, taille des fichiers, délai d’attente, au-delà, il faut payer. Et rien ne garantit que le service ne conserve pas une copie des sites que vous aspirez. Pour un usage ponctuel et privé, un logiciel de bureau reste plus sûr et plus complet.
Un autre angle mort des services en ligne : la confidentialité des données aspirées. Si vous sauvegardez un site contenant des informations personnelles ou professionnelles sensibles, les confier à un tiers est un risque inutile. Un logiciel de bureau comme HTTrack garde tout en local, sans jamais envoyer la moindre information sur vos habitudes de navigation à un serveur distant.
Que faire de votre copie une fois téléchargée
Une copie aspirée n’est utile que si vous savez la retrouver et la lire. Quelques réflexes simples évitent de se retrouver avec un dossier de 12 Go impossible à naviguer.
Les utilisateurs réguliers d’aspirateurs recommandent une organisation systématique : un dossier par site, avec la date de téléchargement dans le nom. Cette habitude devient précieuse quand vous aspirez plusieurs versions d’un même site à des moments différents. Vous pouvez comparer les évolutions, retrouver une version antérieure d’une page supprimée, ou simplement savoir quelle copie est la plus récente.
- Rangez chaque site dans un dossier dédié, avec la date de téléchargement dans le nom.
- Ouvrez la copie avec un navigateur en mode hors ligne pour vérifier que la navigation interne fonctionne.
- Supprimez les fichiers inutiles, comme les scripts de suivi, les publicités ou les images décoratives.
- Conservez le fichier de projet de l’aspirateur si vous prévoyez une mise à jour incrémentale.
Questions fréquentes
Peut-on aspirer un site web avec l’intelligence artificielle ?
Oui, depuis 2024 plusieurs outils combinent IA et crawling. Vous décrivez en langage naturel les pages à récupérer, l’IA identifie les sélecteurs CSS et lance la copie. Le gain de temps est réel sur les sites complexes, mais le résultat reste à vérifier manuellement.
Un aspirateur de site peut-il télécharger une vidéo YouTube intégrée ?
Non. Les aspirateurs classiques copient les fichiers hébergés sur le domaine cible. Une vidéo YouTube est chargée depuis les serveurs de YouTube, pas depuis le site qui l’intègre. Pour ce type de contenu, il faut un outil dédié au téléchargement de vidéos en streaming.
Est-il légal d’aspirer un site pour le consulter hors ligne ?
Pour un usage strictement personnel, la consultation hors ligne d’une page accessible publiquement est généralement tolérée. La redistribution des contenus aspirés, même partielle, enfreint le droit d’auteur. Vérifiez toujours les conditions d’utilisation du site cible avant un crawl massif.
Combien de temps faut-il pour aspirer un site moyen ?
Tout dépend de la taille du site et de la vitesse de crawl configurée. Un blog de quelques centaines de pages peut prendre moins d’une heure avec une connexion correcte. Un site de plusieurs milliers de pages, avec un délai d’une seconde entre les requêtes, peut demander plusieurs heures, voire une nuit complète.
Le bon réflexe n’est pas de télécharger plus, mais de télécharger mieux. Un aspirateur bien configuré vous donne une copie fidèle, légale et consultable. Un crawl sauvage vous apporte un dossier illisible et des ennuis potentiels. La différence tient en trois réglages : vitesse, profondeur, filtres.
Pour aller plus loin, NordVPN reste l’option que je recommande pour ce genre de situation.