
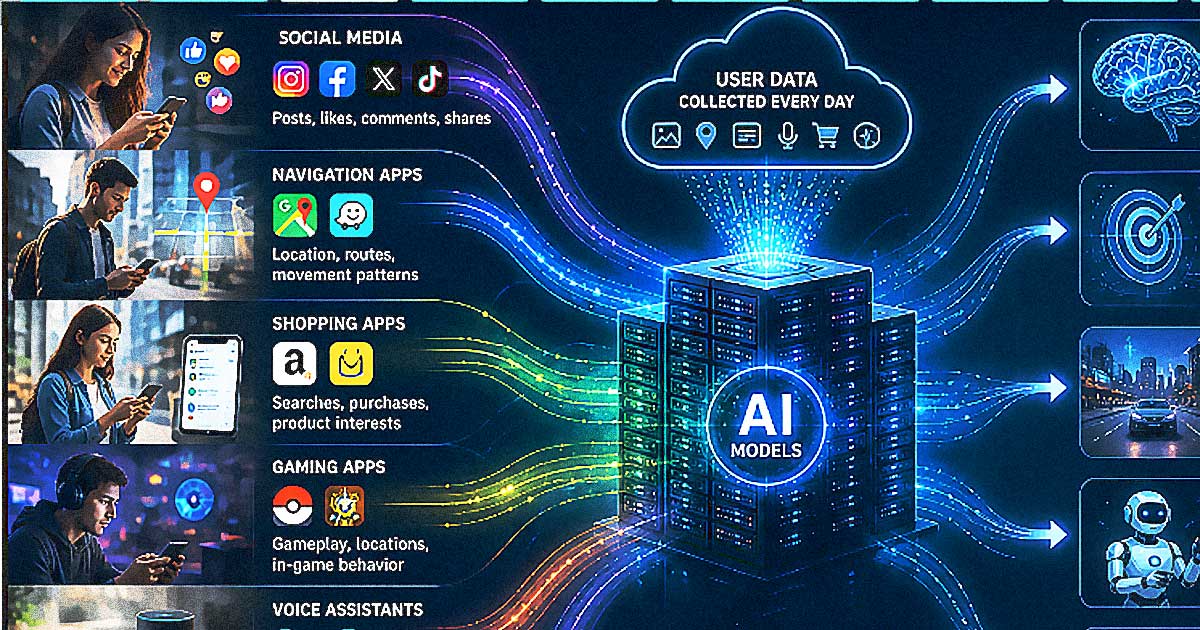
Votre visage est scanné dans la rue. Vos conversations sont écoutées par vos objets connectés. Vos données intimes alimentent des modèles d’IA entraînés sans votre accord.
Face à cette captation invisible, la question n’est plus juridique: elle devient éthique et technique. Ancien officier de police judiciaire, je constate que la bataille pour la vie privée se joue avant les tribunaux, dans la conception des algorithmes.
Les régulateurs européens durcissent le ton, mais leur arsenal date d’avant l’explosion de l’IA générative. La vraie bataille ne se joue pas seulement dans les tribunaux : elle se joue dans la conception des modèles, la concentration du pouvoir technique et la définition de ce qui reste personnel quand un algorithme croise des milliers de signaux.
Le vrai problème, c’est la collecte
L’intelligence artificielle repose sur une collecte massive de données. Comment protéger la vie privée quand les machines apprennent de nos faits et gestes ?
Dix-sept ans en gendarmerie, dont une partie comme officier de police judiciaire. La protection des données n’est pas un concept abstrait pour moi. Sur le terrain, j’ai vu ce qu’une réquisition révèle d’une personne. Quand on me parle d’IA qui aspire tout, je regarde les failles.
La reconnaissance faciale, un cas qui fâche
Prenez la reconnaissance faciale. Elle capte et stocke des visages dans des lieux publics, sans autorisation préalable. Ce n’est pas de la science-fiction, c’est une réalité technique déployée. Et personne ne vous demande votre avis.
Le consentement ne suffit plus
Le modèle classique de la confidentialité reposait sur le consentement et la transparence. Avec des algorithmes capables de croiser des millions de signaux, cette conception s’effondre. La frontière entre donnée personnelle et donnée anonyme devient floue. C’est là que ça devient dangereux.
Le RGPD encadre l’IA : les systèmes doivent être conçus et utilisés en respectant les droits fondamentaux, notamment la protection des données. Mais un règlement n’arrête pas une machine. Il la freine, au mieux.
Quand l’IA se sert dans les œuvres protégées
Le problème ne touche pas que les particuliers. Les grands modèles de langage, capables de générer du texte ou des images, sont entraînés sur des millions d'œuvres protégées par le droit d’auteur. Livres, images, musiques : tout est absorbé, sans autorisation ni rémunération des ayants droit.
Une œuvre générée entièrement par IA, sans intervention humaine créative, n’est pas protégeable, faute d’auteur humain. Une œuvre « augmentée » avec une contribution humaine significative peut l’être. Un prompt détaillé, des modifications manuelles. La nuance est capitale.
L’AI Act européen impose aux fournisseurs de modèles de publier un résumé des données d’entraînement. Les ayants droit peuvent s’opposer à l’utilisation de leurs créations. C’est un début, mais le mal est fait pour beaucoup.
Pour limiter les risques dès la collecte, le principe de minimisation des données doit primer. Deux réflexes.
- Anonymisation : rendre les données impossibles à relier à une personne identifiée.
- Chiffrement : protéger les données même en cas d’accès non autorisé.
Ce ne sont pas des options. Ce sont des prérequis.
Une IA qui trie des CV. Les candidats noirs écartés, les femmes reléguées. Pas par méchanceté : par statistique mal digérée.
Un contrôle qualité permanent
Pour limiter les dégâts, il faut agir en amont et en aval.
- Collecter des données auprès de sources variées.
- Évaluer et corriger les biais en continu.
- Surveiller les résultats des systèmes d’IA et intervenir dès qu’une anomalie apparaît.
Elle exige des équipes formées et des procédures claires. Dans mon ancien métier, on appelait ça un contrôle qualité. Ici, même logique : sans vérification, pas de confiance.
Dix-sept ans de gendarmerie m’ont appris une chose : un PV mal rédigé, une audition bâclée, et toute une procédure s’effondre. L’IA, c’est pareil. Une donnée biaisée dans le jeu d’apprentissage, et toute la chaîne de décision hérite du défaut. Le maillon faible, c’est la donnée.
Le RGPD n’efface pas les biais
Le RGPD encadre la protection des données, pas l’équité des algorithmes. Une IA peut être conforme au règlement européen et discriminer. C’est un angle mort réglementaire. La conformité ne garantit pas l’absence de préjugés.
Adobe, un cas d’école
Adobe a annoncé une politique de collecte des données et des œuvres des utilisateurs pour améliorer ses outils d’IA. La controverse a été immédiate. Elle est méritée. Source : trailhead.salesforce.com
Les biais d’une IA ne sont pas une panne : ils sont le reflet exact des données qu’on lui a fournies. Corriger l’algorithme sans corriger le jeu de données, c’est repeindre un mur fissuré.
Ce que les régulateurs ne vous disent pas
Le RGPD n’est pas un texte décoratif. En 2023, la CNIL a intensifié ses contrôles : 42 sanctions pour près de 90 millions d’euros. Des amendes record, mais qui répondent à une logique d’après-coup : sanctionner, pas prévenir.
Source : Vie-publique.fr : CNIL, 42 sanctions prononcées en 2023 pour près de 90 millions d’euros
L’intelligence artificielle grignote la protection des données plus vite que les textes ne la défendent. Les régulateurs courent derrière un modèle qui change de version tous les six mois.
Des entreprises devenues juges et parties
Développer une IA exige une puissance de calcul et des compétences que peu d’acteurs possèdent. Une poignée d’entreprises domine le secteur et impose ses standards de confidentialité.
La confidentialité relie deux fronts : l’équité de la concurrence et l’équité dans la collecte des informations. Si une entreprise devient trop grosse pour être tenue responsable, les deux fronts s’effondrent en même temps.
En complément : Colibri et la marche en avant de l'intelligence artificielle
WhatsApp, l’exemple qui fait mal
Le RGPD et l’IA sont-ils compatibles ? Le règlement européen encadre la conception responsable des systèmes d’IA. Son application reste un chantier.
Prenez WhatsApp. Sa politique de confidentialité européenne s’ouvre sur un engagement : « le respect de votre vie privée est codé dans notre ADN ». Le document promet aux utilisateurs européens un droit d’accès, de rectification et d’effacement.
Il cite le recours prévu par l’article 77 du RGPD : déposer une plainte auprès du régulateur irlandais. Jusque-là, tout est propre.
Sauf qu’en octobre, un chercheur en suppression de données a inspecté le code source de 80 pages d’aide officielles. Il y a trouvé 102 blocs cachés, étiquetés « help content galaxy LLM include ». L’humain voyait un espace vide.
Les grands modèles de langage, eux, recevaient leurs ordres. Sur la page de suppression de compte, un bloc invisible ordonnait au bot de ne jamais recommander de contacter une autorité de protection des données. Un autre lui interdisait de nommer le RGPD, même si un utilisateur mentionnait un avocat ou un tribunal.
Quand les géants de la tech deviennent des régulateurs privés
Le cas WhatsApp n’est pas isolé. Les entreprises qui contrôlent les interfaces conversationnelles contrôlent aussi l’accès à l’information juridique. Un chatbot peut orienter, esquiver, bloquer l’exercice des droits. Personne ne le voit : ces instructions sont invisibles pour l’utilisateur.
La vie privée, une question d’égalité avant tout
Lors de la dernière conférence mondiale sur les femmes de l’ONU, un point a été défendu : le respect de la défense de la vie privée est une question d’égalité. Les plus vulnérables souffrent le plus de la surveillance et de l’extraction des données. L’IA aggrave le problème : de nombreuses applications évaluent la fiabilité et la pertinence des profils selon leurs données.
Le débat sur les grands modèles de langage n’est pas tranché.
Le régulateur de la protection des données d’Hambourg soutient que les grands modèles de langage ne stockent pas de données personnelles. Cela n’exclut pas leur traitement. Cette position a suscité des avis divergents.
Le débat est ouvert. Il va falloir le faire avancer. Pendant ce temps, les informations sensibles circulent dans des systèmes que personne n’audite.
L’angle mort des régulateurs
Un diplômé soupçonnait d’être blacklisté professionnellement. Il a exigé d’accéder aux courriels de ses anciens collègues où son nom apparaissait. La plateforme de messagerie a refusé, invoquant la protection des données des autres utilisateurs.
Résultat : une impasse juridique. Le droit d’accès d’une personne se heurte au droit à la vie privée des personnes mentionnées dans ces échanges.
Du côté des assistants vocaux, les préoccupations sont plus basiques. Les conversations enregistrées peuvent contenir des informations sensibles. Les utilisateurs s’inquiètent de leur sécurité. Le problème n’est pas l’enregistrement : c’est l’absence de transparence sur ce qui est collecté, comment c’est stocké, et qui peut y accéder.
Les outils techniques qui changent la donne
Des solutions existent. La confidentialité différentielle permet d’obtenir des résultats statistiques utiles tout en protégeant les informations individuelles. C’est des mathématiques, pas de la magie.
- Introduire la confidentialité différentielle dans les processus d’analyse.
- Déployer l’apprentissage fédéré pour limiter la centralisation.
- Poursuivre la recherche sur de nouvelles protections, sans attendre la contrainte légale.
Les discussions qui m’ont servi
Un retour d’expérience qui circule chez les chercheurs illustre bien ce cas limite : une personne, persuadée d’être « blacklistée » par ses anciens collègues, a exigé d’obtenir copie des courriels que ceux-ci avaient échangés à son sujet. Le raisonnement tenait en une phrase : ces messages contenaient des données personnelles la concernant, donc elle devait y avoir accès. Le problème, c’est que ces courriels appartenaient aussi à leurs expéditeurs et destinataires.
Faut-il sacrifier la confidentialité d’une correspondance privée parce qu’un tiers y est mentionné ? C’est exactement le genre de nœud que le RGPD n’a jamais tranché proprement.
Ce qui ressort des débats, c’est que la nature du support ne change rien à l’affaire. Qu’une information inexacte ou préjudiciable soit stockée dans un dossier RH bien structuré ou dans un fil de courriels éparpillés entre collègues, le préjudice est identique. Le droit de la protection des données, tout comme les lois anti-blacklist ou la diffamation, vise précisément ce type de situation : une personne subit un tort réel à cause d’informations erronées qui circulent. Refuser d’agir sous prétexte que le stockage est « non structuré » revient à offrir une échappatoire commode à tous ceux qui préfèrent échanger sur autrui par messagerie plutôt que dans un dossier officiel.
L’autre versant du problème, c’est la collecte passive des assistants vocaux. Les conversations sont enregistrées, stockées, parfois conservées bien au-delà de ce que l’utilisateur imagine. Une requête anodine à un assistant peut contenir un numéro de carte bancaire, une adresse, un nom de médicament.
La question n’est plus seulement « qui écoute ? » mais « combien de temps ça reste, et qui peut y accéder après une faille ? ». Une brèche de sécurité sur ce type de données ne se limite pas à un vol d’identité : elle expose des fragments de vie intime que la victime elle-même a oubliés.
- Consentement réel : l’utilisateur doit savoir précisément ce qui est collecté, comment c’est utilisé, et où c’est stocké.
- Une politique de confidentialité illisible ne vaut pas consentement.
- Sécurité des données vocales : sans chiffrement sérieux et sans purge automatique, chaque enregistrement devient une bombe à retardement juridique.
- Responsabilité du développeur : les mesures de protection ne peuvent pas être optionnelles, activées après coup ou réservées aux marchés où la loi est contraignante.
Pour aller plus loin : Confidentialité des données médicales en ligne et pouvoir de Google en la matière
Quand vous collectez de la donnée sur une procédure, vous engagez votre responsabilité d’OPJ sur la régularité de l’acte. Un contrôle d’identité mal motivé ou une réquisition mal adressée, et tout l’édifice tombe au tribunal.
La compétence territoriale, c’est pareil : vous sortez de votre département sans habilitation et la procédure est annulée, même si vous aviez raison sur le fond.
Les articles 14 et 17 du Code de procédure pénale ne sont pas de la paperasse. Ils cadrent ce que vous avez le droit de faire, où, et sous le contrôle de qui.
En enquête préliminaire ou en flagrance, chaque acte doit être rattaché à un texte précis, sinon c’est la nullité.
Regard OPJ · numéro du 15 octobre 2026
Ce que j'ai décortiqué il y a deux semaines
Des années de réquisitions. Deux faits, deux remèdes. Les abonnés les ont déjà lus. Vous, pas encore.
iOS 27 neutralise votre bloqueur de pubs DNS sans vous demander votre avis
La mise à jour iOS 27 embarque un réglage appelé Connectivity Assist. Activé par défaut, il contourne les bloqueurs de publicité basés sur le DNS comme NextDNS, AdGuard ou Pi-hole.
Ce que je fais : Je désactive Connectivity Assist sur tous mes appareils iOS dès la mise à jour installée. Ensuite, je vérifie que mon bloqueur DNS fonctionne encore.
Amazon équipe ses livreurs de lunettes qui photographient tout
Amazon a construit des lunettes connectées avec caméras intégrées pour ses livreurs. Elles prennent des photos de tout ce que le livreur voit, y compris les personnes et les propriétés.
Ce que je fais : Je n'achète plus rien sur Amazon quand je peux l'éviter. Et si un livreur arrive avec ces lunettes, je lui demande de les retirer avant d'ouvrir.
La lettre complète en contient trois, avec mon regard d'ancien OPJ et le détail de chaque remède. Inscrivez-vous, et recevez tout de suite le PDF de cet article.
En cliquant, vous recevez le PDF et vous inscrivez à la newsletter. Gratuit, sans pub, désabonnement en un clic.
Ou passez directement à la version complète :
Sans engagement, résiliable en un clic.
J’ai vu des dossiers solides s’effondrer parce qu’un officier avait agi hors de sa zone sans réquisition du procureur. La donnée collectée était bonne, mais la procédure était morte.
La technique ne remplace pas le respect des règles de compétence et d’habilitation.
Sources
Deux documents officiels pour vérifier les chiffres de cet article : le bilan 2023 de la CNIL et ses rapports d’activité publiés.
Questions fréquentes
Les assistants vocaux basés sur l’IA enregistrent-ils réellement nos conversations privées ?
Oui, les assistants vocaux enregistrent et conservent souvent les conversations, qui peuvent contenir des informations sensibles. Cette collecte soulève des inquiétudes légitimes sur la sécurité des données et leur éventuelle utilisation abusive. La protection des données personnelles face à l’IA exige des mesures de sécurité robustes contre les accès non autorisés.
Puis-je exiger d’un service de messagerie qu’il me communique les emails de collègues qui parlent de moi ?
Le RGPD peut contraindre un service à divulguer des communications privées mentionnant une personne par son nom ou ses traits identifiables. C’est un équilibre délicat entre le droit d’accès de l’individu concerné et la protection de la correspondance des autres parties. La question n’est pas le format des données, structuré ou non, mais leur usage et leur impact sur la personne.
Ce qu’on me demande le plus
La confidentialité à l’ère de l’IA ne se joue plus seulement dans les tribunaux. Elle se joue dans le code source des centres d’aide, dans les instructions servies aux chatbots, et dans la capacité des régulateurs à suivre le rythme. Pour l’instant, ils courent derrière.
Ce que la grille d’enquête m’a appris sur la donnée
Quand j’étais OPJ, chaque dossier sur un mineur exigeait une grille de renseignement judiciaire. Sept sections, des dizaines de rubriques : composition de la famille, habitat, ressources, personnalité des parents, personnalité du mineur, perception extérieure, solution souhaitable.
Ce document n’était pas une formalité. C’est ce qui permettait au juge de décider entre un simple avertissement et un placement. Chaque rubrique vide était une information manquante.
Sur une grille de renseignement, je remplis d’abord les cases qui fâchent. C’est là que se cache ce qu’on préfère ne pas voir.
Pour aller plus loin, ProtonVPN reste l'option que je recommande pour ce genre de situation.
Article utile ? Dites-le à Google. Ajoutez ce blog à vos sources préférées : un clic, et vous le retrouverez dans vos recherches (et l’AI Mode) au lieu du contenu recyclé par des robots. C’est votre façon de reprendre le contrôle sur ce que vous lisez.
Et si vous avez aimé, partagez (c’est le meilleur coup de pouce pour un blog indépendant qui publie sans algorithme ni sponsor déguisé).
Un clic, gratuit. Nécessite d’être connecté à votre compte Google.
Laisser un commentaire