
Vous interrogez Claude Code ou Opencode toute la journée : chaque token compte double. Caveman propose une compétence qui force l’agent à répondre comme un homme des cavernes: moins de mots, moins de politesse, moins de remplissage. Le gain promis est alléchant. Derrière les benchmarks flatteurs, la réalité est plus nuancée que les threads Twitter ne le laissent paraître.
L’équipe derrière Caveman a publié un benchmark contrôlé de 54 exécutions, dont 18 paires comparant une réponse directe et une réponse Caveman. Les chiffres avancés sont précis : 33,2 % de tokens d’entrée en moins rapportés par le fournisseur, avec 18 contrôles de réponses exactes réussis. L’intervalle de confiance à 95 % s’étend de 14,6 % à 48,5 %. Voilà pour les données brutes.
Ce que raconte le benchmark officiel
Le dépôt Caveman documente une compression qui agit sur la sortie du modèle, pas sur votre requête. Vous payez toujours l’intégralité du contexte envoyé, seul le texte généré fond.
Ce détail change tout quand vous travaillez sur de gros fichiers : un prompt de 40 000 tokens reste facturé plein tarif, même si la réponse tient en trois lignes.
Ces mesures portent sur six jeux de sorties déterministes. Pas du trafic de production. Les artefacts bruts ne sont pas publiés.
Rien ne garantit le même gain sur votre projet. C’est là que le bât blesse.
La formulation « jusqu’à 75 % moins cher » circule beaucoup. Trop générale. C’est un maximum théorique, pas une moyenne constatée. Beaucoup de reposts oublient la nuance.
Pour bien comprendre ce qu’est un benchmark, rappelons que cet outil méthodologique sert avant tout à comparer objectivement des performances dans des conditions identiques. Le problème, c’est que cette standardisation est précisément ce qui l’éloigne des conditions réelles d’utilisation. Un benchmark mesure ce qu’il mesure, ni plus, ni moins. Les écarts constatés en laboratoire ouvrent des pistes d’amélioration, mais ne garantissent jamais un transfert direct vers votre environnement de travail.
L’équipe Caveman a fait un travail honnête : elle a mesuré, publié les chiffres, laissé les limites visibles. C’est rare dans l’écosystème des plugins pour agents de code.
Pourquoi l’écart entre promesse et réalité
Un benchmark en laboratoire mesure des réponses uniques, calibrées, reproductibles. Votre session Claude Code mélange questions courtes, relances, corrections de code, lectures de fichiers. Le comportement du modèle varie à chaque tour. Impossible à reproduire en conditions contrôlées.
La réduction des tokens de sortie est réelle
Son ampleur dépend du type de réponse : une explication technique verbeuse se compresse beaucoup, un bloc de code minimal se compresse peu. Tout dépend de ce que vous demandez.
La tokenomics des agents de codage ajoute une couche. La consommation d’un agent varie d’un facteur 10 selon la complexité de la tâche. Toute prédiction de gain devient volatile.
Un benchmark qui mesure 33 % d’économie sur des jeux de test ne peut pas anticiper ce facteur. C’est structurel, pas une faiblesse du projet.
Installer Caveman sans se prendre la tête
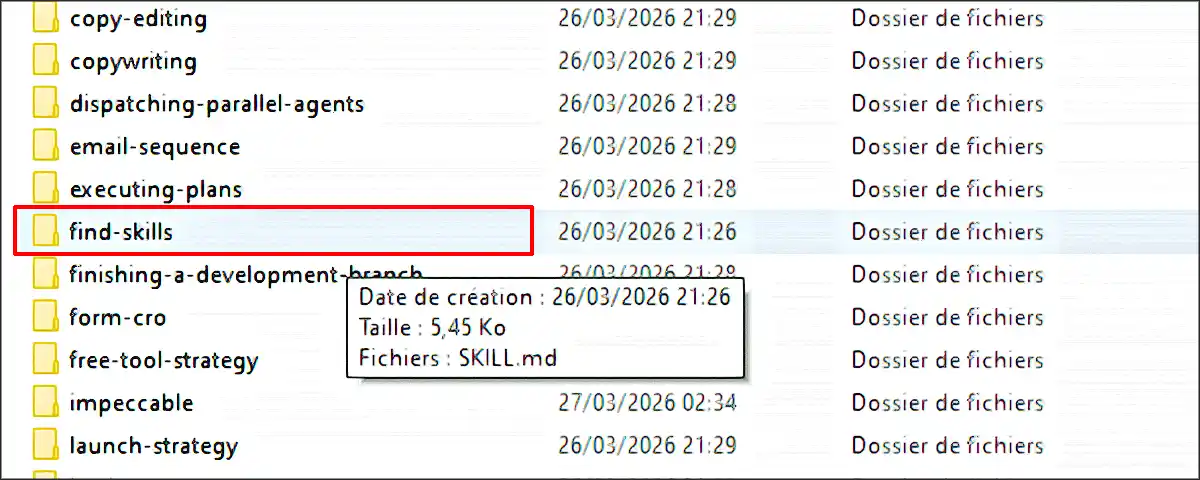
L’installation est simple. Le dépôt GitHub de JuliusBrussee contient les fichiers de compétence dans un dossier skills/caveman/. Vous les placez dans le répertoire de compétences de votre agent. Pas de dépendances, pas de config compliquée.
Pour Claude Code, cela passe par le dossier .claude/skills/. Pour Opencode, même principe : l’agent charge le fichier SKILL.md qui contient les instructions de compression. C’est le genre d’installation qu’on aimerait voir plus souvent.
Le guide d’installation officiel mentionne une commande : npx -y github:JuliusBrussee/caveman -- --with-init. Elle est sûre à ré-exécuter, elle écrit la même règle dans AGENTS.md sans doublon. La commande simple (npx -y github:JuliusBrussee/caveman) ne se lance qu’une fois : une seconde exécution ajoute une copie. Ce détail sépare une installation propre d’un contexte pollué.
- Récupérez le dépôt caveman depuis GitHub.
- Copiez le dossier de la compétence dans le répertoire de skills de votre agent.
- Activez le mode d’intensité qui vous convient (light, full ou ultra).
- Testez sur une requête simple avant de l’utiliser en production.
Pour les utilisateurs d’Antigravity, une vidéo de configuration couvre tout le processus. Même principe : on place le fichier de compétence au bon endroit, on ajuste le mode, l’agent applique les règles de compression dès la requête suivante.
Les modes d’intensité
Caveman propose trois niveaux de concision. Le mode full est activé par défaut.
- Light : concision légère, le texte reste fluide.
- Full : suppression du remplissage, le mode par défaut.
- Ultra : conjonctions supprimées, flèches pour remplacer la causalité, un mot quand un seul suffit.
| Mode | Ce que ça change concrètement |
|---|---|
| Light | Concision légère, garde les connecteurs logiques |
| Full | Supprime remplissage et politesse, phrases courtes |
| Ultra | Abréviations partout, flèches de causalité, un mot si possible |
Le mode full reste le plus équilibré au quotidien
L’ultra devient illisible si vous relisez la réponse plusieurs jours plus tard. J’ai fait le test : relire du mode ultra une semaine après, c’est déchiffrer des notes prises en speed.
La distinction entre concision et précision compte ici. L’Académie française le rappelle : la concision prête indifféremment son secours à la fausseté comme à la vérité, tandis que la précision ne se conçoit pas sans justesse et sans clarté. Le mode ultra sacrifie parfois la précision sur l’autel de la brièveté. À vous de placer le curseur.
Le piège des tokens d’entrée
Un skill qui allège les réponses ne touche pas à la facture d’entrée. Si votre session traîne depuis 2 heures, chaque nouveau message renvoie l’historique complet au modèle, et cette part reste identique avec ou sans Caveman.
La vraie économie sur l’entrée passe par un nettoyage manuel du contexte (nouvelle conversation, résumé des échanges précédents) ou par un outil dédié à la compression d’entrée.
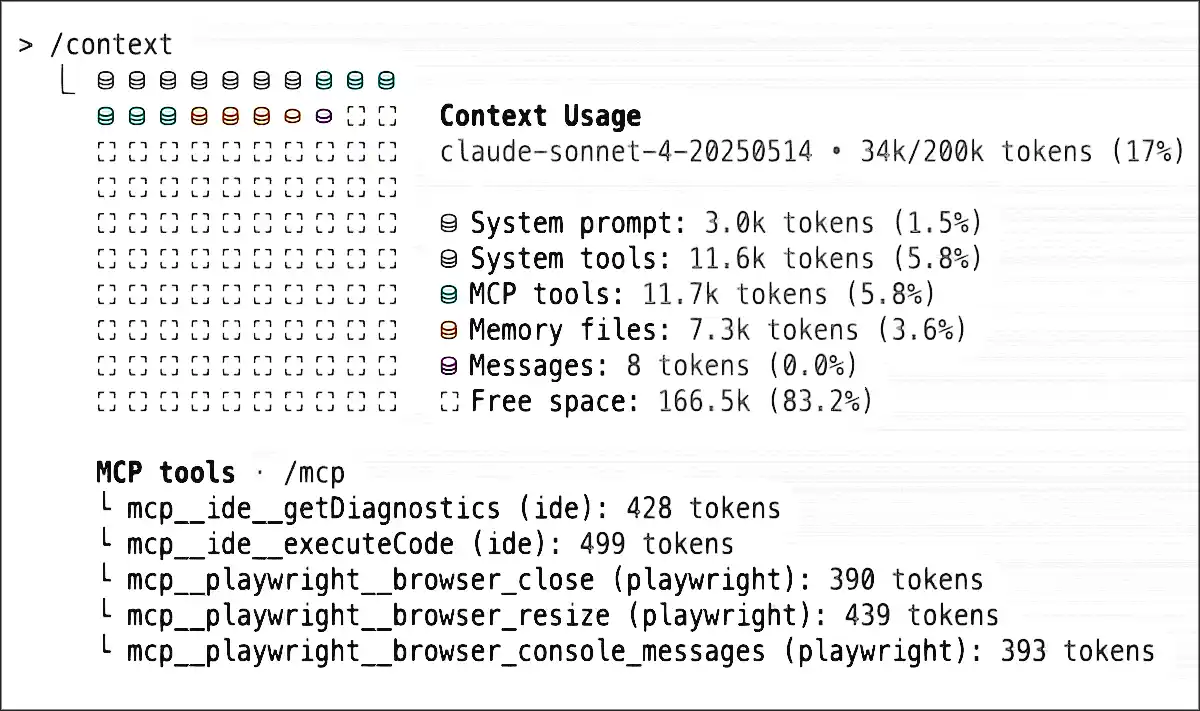
Charger la compétence Caveman ajoute un fichier Markdown d’instructions dans le contexte. Ce fichier pèse en tokens d’entrée. Personne n’en parle dans les threads Twitter qui vantent l’outil.
Sur une question unique et courte, le coût d’entrée peut dépasser l’économie réalisée en sortie. Le benchmark le reconnaît : le gain net n’apparaît que lorsque le cache de requêtes entre en jeu. C’est mathématique.
Dès que vous enchaînez des questions de suivi dans la même session, les instructions de Caveman sont mises en cache. Vous ne les payez plus à chaque tour. L’économie sur les tokens de sortie devient un gain net. Le point de bascule dépend de votre volume de questions.
Un utilisateur a calculé que la compétence Caveman représente environ 4 % du total d’une session type. Ce n’est pas anodin, mais ce n’est pas non plus rédhibitoire. Le vrai piège, c’est de croire que cette surcharge d’entrée disparaît par magie.
Elle se dilue dans la durée de session, à condition que le cache fasse son travail. Sur une session courte, elle reste pleinement visible.
La hausse des prix des tokens force les entreprises à la sobriété. Caveman prend son sens dans ce contexte. Les fournisseurs de tokens agissent comme des dealers : les premières doses sont gratuites pour vous accoutumer, ensuite il faut passer à la caisse.
Pour une entreprise, le passage à l’échelle transforme une économie marginale en ligne budgétaire. Le coût d’entrée du fichier de compétence devient un investissement amorti sur des centaines de sessions.
Questions fréquentes
Caveman fonctionne-t-il avec d’autres modèles que Claude ?
Le skill est conçu pour Claude Code et son écosystème. Sur d’autres modèles, il faut vérifier la compatibilité du dépôt avant de l’installer, car le format des instructions varie.
Faut-il un compte payant pour tester Caveman ?
Le skill s’installe côté client, mais son intérêt réel n’apparaît qu’avec une consommation mesurable. Sur un compte gratuit, vous verrez la différence de style sans pouvoir chiffrer l’économie.
Le skill modifie-t-il la qualité du code généré ?
Sur des tâches courtes et bien cadrées, la qualité reste stable. Sur des demandes complexes, la concision peut supprimer des explications utiles, à vous de juger selon le contexte.
La concision améliore-t-elle la précision ?
Forcer une réponse courte oblige le modèle à trancher. Sur des tâches de classification ou de correction de code, cette contrainte réduit les digressions et les précautions inutiles qui noient la vraie réponse.
Sur une question ouverte (architecture, choix stratégique), la brièveté coupe des nuances utiles. Le skill n’améliore pas le raisonnement, il retire ce qui l’encombre.
Une étude citée dans les discussions autour de Caveman suggère que limiter les modèles à des réponses brèves améliore la précision de 26 % sur certains benchmarks. L’idée est contre-intuitive : en supprimant le bavardage, le modèle se concentre sur l’essentiel. Séduisant Source : andrew.ooo
Je reste prudent sur ce chiffre. Les benchmarks de précision varient selon les tâches. Ce qui vaut pour une réponse factuelle courte ne vaut pas pour une explication d’architecture complexe. Un LLM qui répond en trois mots n’est pas plus fiable.
La valeur de Caveman n’est peut-être pas la précision. C’est la lisibilité. Un flux de travail où chaque réponse tient en trois lignes se relit plus vite.
En développement, la vitesse de lecture compte autant que la vitesse de génération. On sous-estime ce point.
La précision rédactionnelle repose sur deux piliers : la clarté, qui permet au lecteur de comprendre le message, et la concision, qui évite les informations superflues et les malentendus. Caveman force la seconde, mais ne garantit pas la première. Un message court et ambigu reste un mauvais message. Le mode light, qui conserve les connecteurs logiques, peut donc être plus précis que le mode ultra.
Ce que Caveman supprime, ce qu’il conserve
La compétence applique des règles de compression. Les termes techniques, les blocs de code et les messages d’erreur restent intacts. Ce qui disparaît, c’est le gras verbal autour. Pas de perte d’information technique.
| Action | Exemple |
|---|---|
| Supprimer | Articles, mots de remplissage, formules de politesse |
| Raccourcir | « implement a solution for » devient « fix » |
| Conserver | Termes techniques, code, messages d’erreur |
Pour un développeur qui lit une réponse pour extraire une information, c’est un gain de confort. Pour quelqu’un qui découvre un projet, la perte de contexte gêne. Tout dépend de votre familiarité avec la base de code.
L’étymologie le confirme : les mots précision et concision remontent tous deux au latin caedere, « tailler les arbres », puis plus largement « abattre en coupant ». La concision est littéralement une coupe. Caveman ne fait qu’automatiser ce geste d’élagage.
Mais tout jardinier sait qu’une taille trop agressive peut tuer la plante. La question n’est pas de couper, c’est de savoir quoi conserver.
Mon avis sur ce genre d’outil
Un point que personne ne mentionne assez : la brièveté forcée transforme aussi la relation au prompt. Vous arrêtez d’écrire des demandes fleuves, vous
Le skill ne remplace pas une bonne hygiène de contexte. Il la rend visible, parce qu’il vous montre enfin combien de mots vous payez pour rien.
J’ai passé du temps dans des environnements où chaque octet comptait. À Saint-Pierre-et-Miquelon, la connexion satellite imposait une latence et des quotas qui forçaient à la concision. On apprend vite que la verbosité est un luxe. Et que la précision chirurgicale devient une seconde nature.
Je me méfie des plugins qui promettent des économies magiques. Le benchmark de Caveman est honnête sur ses limites. Mais entre un gain mesuré à 33 % sur des jeux de test et un « jusqu’à 75 % » repris partout, il y a un monde. Un monde que les threads Twitter franchissent allègrement.
Les retours d’utilisateurs sur ce type d’outil sont contrastés, et c’est sain. Certains y voient un confort de lecture immédiat, d’autres une couche de complexité pour un bénéfice marginal. La vérité se situe entre les deux, et dépend de votre volume d’usage et de votre tolérance à la verbosité.
Quel est le gain réel de tokens avec Caveman ?
Le benchmark officiel mesure 33,2 % de tokens d’entrée en moins sur des tests contrôlés, avec un intervalle de confiance allant de 14,6 % à 48,5 %. Le chiffre de 75 % souvent cité est un maximum théorique, pas une moyenne constatée.
Caveman est-il rentable pour une seule question ?
Sur une requête unique, le coût d’entrée du fichier de compétence peut annuler l’économie de sortie. Caveman devient rentable sur des sessions longues où le cache de requêtes s’active.
Peut-on ajuster le niveau de concision ?
Oui. Trois modes sont disponibles : light (concision légère), full (défaut, suppression du remplissage) et ultra (abréviations extrêmes avec flèches de causalité).
Caveman face aux limites techniques
| Situation | Ce que Caveman ne résout pas | Le vrai coût caché |
|---|---|---|
| Vous avez déjà un system prompt qui impose la concision | Le skill ajoute une couche de tokens d’entrée supplémentaire avant même que Claude ne génère quoi que ce soit | Sur un plan Pro à 20 €/mois, chaque session alourdie de 200-300 tokens d’instructions représente quelques centimes par jour, mais sur un usage intensif en Claude Code, ça chiffre en euros à la fin du mois |
| Vous plafonnez le max_tokens à 1500 pour contrôler les coûts | Le skill compresse le style mais pas la structure : si Claude doit produire un JSON ou un tableau, la troncature reste brutale | Les réponses coupées en plein milieu obligent à relancer la génération, ce qui double le coût de la requête initiale |
| Vous utilisez un thinking budget élevé pour les tâches complexes | La phase de réflexion n’est pas affectée par le skill, elle continue de consommer des tokens invisibles | Sur un plan Max à 100 €/mois, le thinking représente souvent 40 à 60 % du total facturé, Caveman n’y touche pas |
| Vous travaillez sur un projet avec un contexte de 50k tokens d’entrée | Le skill ne compresse pas ce que vous envoyez, uniquement ce que Claude renvoie | Si votre prompt d’entrée est bavard, Caveman ne vous fera économiser que 15-20 % du total, pas les 65-75 % annoncés |
Sur une session courte, la différence saute aux yeux. Sur une session longue, elle se dilue dans le coût du contexte et devient difficile à isoler sans mesure précise.
Le seul moyen fiable de trancher reste de comparer vos propres relevés de consommation avant et après, sur des tâches identiques.
Le terrain, c’est autre chose
Un retour d’expérience qui change des benchmarks officiels : des utilisateurs ont testé réduire ses tokens avec un skill caveman sur leurs propres projets et leurs mesures de coût ne collent pas avec les promesses. Les chiffres de réduction annoncés ne se retrouvent pas dans leurs relevés de facturation. Leur est assez directe : ces « hacks » de concision relèvent du snake oil, et ce qui a réellement fonctionné pour eux, c’est d’indexer le code avec un modèle local d’embeddings. Le processeur trinque un peu, mais le temps d’exécution et la consommation de tokens chutent significativement.
Pourquoi cette approche marche ? Parce qu’un grand modèle de langage, livré à lui-même, brute force les mots et les enchaîne dans des commandes de recherche classiques. La recherche sémantique, elle, compare les similarités avant d’envoyer quoi que ce soit au modèle. Vous faites moins de force brute, donc moins d’allers-retours. Le coût, évidemment, c’est d’indexer tout le code en amont. Et l’auteur de ce retour prévient : ses benchmarks datent un peu, et le bruit statistique reste un facteur. Prenez ça avec des pincettes.
Autre point qui fait débat : le déclencheur du skill. La description prévoit des expressions comme « mode caveman » ou « moins de tokens », mais certains développeurs se demandent pourquoi ne pas simplement brancher un hook qui détecte ces mots-clés par regex. L’outil existe déjà pour intercepter la requête utilisateur et injecter du contexte automatiquement. Et pour la commande explicite /caveman, le système de skills l’invoque de toute façon. Une partie du mécanisme pourrait se passer du skill lui-même.
Un point de vue plus radical ressort des discussions : au lieu de faire parler l’IA comme un homme des cavernes, certains préfèrent la faire raisonner comme un ingénieur. Leur alternative n’est pas un skill de concision, mais un framework qui structure la réflexion de l’agent avant la réponse. Le modèle commence par choisir son approche (développeur ou ingénieur système, par exemple), puis organise sa pensée par étapes.
La sortie montre ce raisonnement préparatoire, pas seulement le texte final. Pour eux, obtenir la bonne réponse du premier coup, c’est ça qui économise vraiment du temps et des tokens.
Pour qui ce skill est-il vraiment utile ?
Caveman s’adresse d’abord aux développeurs qui utilisent un agent de code au quotidien. Si vous posez des dizaines de questions par session, la compression des réponses devient un confort de lecture et une économie réelle. Le calcul est vite fait.
Si vous utilisez Claude Code occasionnellement, pour une question de temps en temps, le bénéfice est marginal. Le fichier de compétence ajoute de la friction sans apporter grand-chose. Autant rester sur le comportement par défaut.
La décision dépend de votre volume d’usage. Plus vous interrogez l’agent, plus la balance penche vers Caveman. C’est une logique de tarification au volume, pas une baguette magique. Et c’est bien comme ça.
Regard OPJ · numéro du 15 octobre 2026
Ce que j'ai décortiqué il y a deux semaines
Des années de réquisitions. Deux faits, deux remèdes. Les abonnés les ont déjà lus. Vous, pas encore.
Fait 1 sur 2
iOS 27 neutralise votre bloqueur de pubs DNS sans vous demander votre avis
La mise à jour iOS 27 embarque un réglage appelé Connectivity Assist. Activé par défaut, il contourne les bloqueurs de publicité basés sur le DNS comme NextDNS, AdGuard ou Pi-hole.
Ce que je fais : Je désactive Connectivity Assist sur tous mes appareils iOS dès la mise à jour installée. Ensuite, je vérifie que mon bloqueur DNS fonctionne encore.
Fait 2 sur 2
Amazon équipe ses livreurs de lunettes qui photographient tout
Amazon a construit des lunettes connectées avec caméras intégrées pour ses livreurs. Elles prennent des photos de tout ce que le livreur voit, y compris les personnes et les propriétés.
Ce que je fais : Je n'achète plus rien sur Amazon quand je peux l'éviter. Et si un livreur arrive avec ces lunettes, je lui demande de les retirer avant d'ouvrir.
La lettre complète en contient trois, avec mon regard d'ancien OPJ et le détail de chaque remède. Inscrivez-vous, et recevez tout de suite le PDF de cet article.
En cliquant, vous recevez le PDF et vous inscrivez à la newsletter. Gratuit, sans pub, désabonnement en un clic.
Ou passez directement à la version complète :
Sans engagement, résiliable en un clic.
- Usage intensif quotidien : Caveman se justifie pleinement.
- Usage ponctuel : le gain est trop faible pour l’effort d’installation.
- Projets avec beaucoup de code : la compression préserve l’essentiel.
- Documentation à relire : le mode ultra peut nuire à la compréhension.
Un point souvent négligé : la combinaison de Caveman avec la commande /caveman-compress sur votre fichier CLAUDE.md peut amplifier les gains. En compressant le fichier de contexte lui-même, on réduit les tokens d’entrée de manière structurelle, pas seulement les tokens de sortie. C’est une optimisation de second niveau pour les utilisateurs qui veulent aller plus loin.
Au final, Caveman est un outil de niche bien conçu. Il ne révolutionne pas Claude Code, mais il répond à un vrai besoin pour ceux qui passent leurs journées à lire des réponses d’agent. Et c’est déjà pas mal.
La question n’est pas de savoir si Caveman est bon ou mauvais. C’est de savoir si votre usage justifie de compresser chaque réponse. Pour certains, la réponse est oui.
Pour d’autres, la verbosité d’un LLM n’est pas un problème assez coûteux pour mériter un plugin. À vous de voir où vous vous situez.
Ce que j’ai vraiment lu
| caveman/skills/caveman/SKILL.md at main · JuliusBrussee/caveman · GitHub ↗ |
| Caveman Claude: The Token ↗ |
Quand le prompt devient un budget, pas une conversation
Depuis 2009, je vis avec une contrainte que les outils comme Caveman remettent au centre : chaque mot coûte. Pas en euros, mais en attention, en temps de chargement, en positionnement Google.
Quand j’ai lancé desgeeksetdeslettres.com, je rédigeais des articles de 2000 mots sans me demander si la moitié servait à quelque chose. Puis je suis passé par les années SEO où on gonflait les textes pour plaire à des algorithmes qui récompensaient la longueur. Aujourd’hui, avec mon service Maj’Article IA, je fais exactement l’inverse : je traite des centaines d’articles pour en retirer le superflu, resserrer l’information, garder ce qui compte vraiment.
La concision n’est pas une économie, c’est un respect. Celui qu’on doit au lecteur, et maintenant à l’outil.
Pour aller plus loin, NordVPN reste l’option que je recommande pour ce genre de situation.
Article utile ? Dites-le à Google. Ajoutez ce blog à vos sources préférées : un clic, et vous le retrouverez dans vos recherches (et l’AI Mode) au lieu du contenu recyclé par des robots. C’est votre façon de reprendre le contrôle sur ce que vous lisez.
Et si vous avez aimé, partagez (c’est le meilleur coup de pouce pour un blog indépendant qui publie sans algorithme ni sponsor déguisé).
Un clic, gratuit. Nécessite d’être connecté à votre compte Google.
Encore un article qui vend du rêve sur un énième outil miracle... J'ai testé ce genre de truc, ça bride Claude plus qu'autre chose. Franchement pas convaincu.