
DeepSeek frappe fort ce 9 septembre 2026. À partir de demain midi heure de Pékin, toutes les requêtes vers le modèle V4 Pro seront automatiquement routées vers V4.1 Flash.
Le prix chute de 70% : 0,60$ par million de tokens en sortie contre 1,98$ actuellement. DeepSeek promet que V4.1 Flash surpasse V4 Pro sur tous les indicateurs.
- Performance
- coût
- vitesse
- temps de complétion
C’est énorme sur le papier. Mais vous me connaissez, je ne prends jamais une annonce marketing pour argent comptant. J’ai établi un plan de validation en 6 étapes pour tester ça demain matin avant de lancer ma prochaine salve de création de contenu.
Si la qualité tient, c’est une révolution pour tous ceux qui font tourner des pipelines IA à grande échelle. Si ça casse, on risque de le payer cher en articles médiocres publiés en automatique.
Vous vous souvenez peut-être de ma gueulante sur la hausse des tarifs V4 Pro il y a quelques semaines. Je pestais contre l’augmentation qui allait plomber mon budget de création de contenu. Et là, coup de théâtre. DeepSeek annonce exactement l’inverse.
- Une baisse massive
- un nouveau modèle qui promet monts et merveilles
- et un routage automatique qui force tout le monde à tester. C’est presque trop beau.
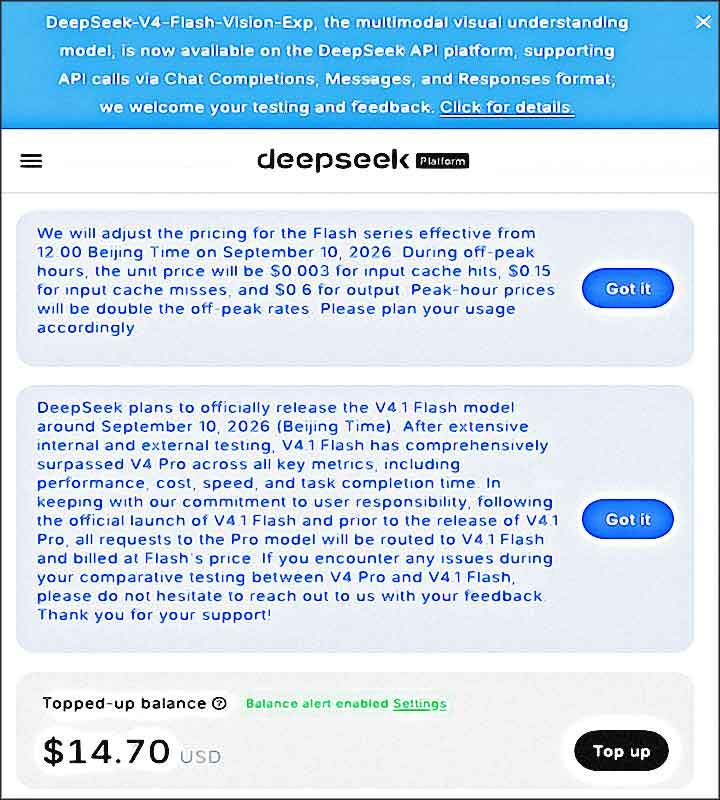
Les nouveaux tarifs DeepSeek Flash V4.1
DeepSeek a publié l’annonce officielle aujourd’hui. Les nouveaux tarifs entrent en vigueur le 10 septembre 2026 à midi heure de Pékin (soit 6h du matin chez nous, GMT+2). Voici ce qui change concrètement pour votre portefeuille :
| Type de requête | Tarif off-peak (heures creuses) | Tarif peak (heures pleines) | Comparaison V4 Pro actuel |
|---|---|---|---|
| Input cache hits | $0.003 / 1M tokens | $0.006 / 1M tokens | Donnée non disponible |
| Input cache misses | $0.15 / 1M tokens | $0.30 / 1M tokens | Donnée non disponible |
| Output (génération) | $0.60 / 1M tokens | $1.20 / 1M tokens | $1.98 / 1M tokens (−70%) |
Le chiffre qui tue, c’est ce −70% sur l’output. C’est énorme. Quand vous faites tourner un pipeline qui génère des articles de 2000 mots, vous consommez entre 3000 et 5000 tokens en sortie par article. Multipliez par 100 articles par mois, et vous comprenez pourquoi je saute sur l’occasion.
Mais attention aux heures pleines. DeepSeek double les tarifs pendant les pics d’utilisation. Si vous lancez vos batchs de création à 14h comme moi, vous paierez le prix fort. Il faudra peut-être décaler les traitements la nuit ou tôt le matin pour optimiser les coûts. C’est un détail technique, mais quand vous gérez deux blogs avec 3620 articles, chaque centime compte.
Le routage automatique Pro vers Flash
C’est là que ça devient intéressant. Et un peu flippant aussi. DeepSeek ne se contente pas de lancer V4.1 Flash à côté de V4 Pro. Ils forcent la main.
deepseek-v4-pro seront automatiquement redirigées vers V4.1 Flash. Et facturées au tarif Flash.DeepSeek justifie ça par une promesse audacieuse :
V4.1 Flash surpasse V4 Pro sur tous les indicateurs clés
- Performance
- coût
- vitesse
- temps de complétion des tâches
Ils ont mené des tests internes et externes approfondis. Le résultat serait sans appel.
DeepSeek route automatiquement toutes les requêtes V4 Pro vers V4.1 Flash à partir du 10 septembre, avec facturation au tarif Flash (0,60$ vs 1,98$ par million de tokens en sortie).
Sur le papier, c’est gagnant-gagnant. Vous payez moins cher et vous avez un meilleur modèle. Dans la réalité, j’ai appris à me méfier des annonces trop parfaites. Surtout quand ça touche à mon pipeline de production de contenu.
J’ai déjà failli laisser l’IA réécrire 300 titres de mon blog en automatique. Résultat : catastrophe. Depuis, je valide chaque changement majeur avant de basculer en production.
Mon plan de validation en 6 étapes
Demain matin, avant de lancer ma prochaine salve de création de contenu, je vais exécuter un protocole de validation strict. Pas question de prendre le risque de publier des articles médiocres sans m’en rendre compte. Voici exactement ce que je vais faire :
- Relire la documentation complète des nouveaux tarifs pour bien comprendre les mécaniques de cache et les heures creuses/pleines
- Lancer un article test en mode création avec un SRT vidéo (j’ai deux sujets en réserve : Andor et un bilan lecture)
- Vérifier que tous les gates de qualité passent : évaluation automatique supérieure à 8/10, QA batch complète, absence de tics IA détectables
- Comparer le coût réel de l’article test avec mon baseline actuel (0,30$ en création, 0,055$ en mise à jour, 0,13$ en correction chirurgicale)
- Prendre une décision : feu vert pour la production ou remontée d’alerte si la qualité dégrade
- Nettoyer mon calendrier de tâches et mettre à jour mes prévisions budgétaires si tout est validé
Ce plan peut vous sembler excessif. Mais quand vous automatisez la création de contenu à grande échelle, vous ne pouvez pas vous permettre de publier de la merde sans vous en apercevoir.
Un modèle qui génère des textes fades, des structures répétitives ou des hallucinations factuelles, ça se voit pas toujours au premier coup d’œil. Ça se voit après 50 articles publiés et un taux de rebond qui explose.
Les points critiques à surveiller
Je vais porter une attention particulière à 3 aspects lors de mon test demain
D’abord, la cohérence du style sur les articles longs
V4 Pro tenait bien la charge sur les contenus de plus de 2000 mots. Si V4.1 Flash commence à répéter des structures ou à perdre le fil narratif après 1500 mots, ce sera rédhibitoire.
Ensuite, la gestion des instructions complexes
Mon pipeline utilise des prompts très structurés avec des contraintes anti-détection IA, des règles de vouvoiement, des quotas de tableaux et de listes. Si le nouveau modèle ignore ces consignes ou les applique de façon mécanique, je le verrai immédiatement dans les logs de validation.
Enfin, la qualité du français
J’ai déjà eu des surprises avec des modèles qui traduisaient littéralement depuis l’anglais ou qui produisaient des formulations non-idiomatiques. Demain, je scannerai chaque paragraphe de l’article test à la recherche de ces artefacts.
L’impact sur votre stratégie IA
Si mon test est concluant, ça change beaucoup de choses pour tous ceux qui utilisent DeepSeek en production.
D’abord le budget
Une baisse de 70% sur l’output, c’est mécanique. Vous pouvez soit produire plus de contenu pour le même budget, soit réduire vos coûts et réinvestir ailleurs. Pour ma part, je vais probablement augmenter ma cadence de publication sur mes deux blogs.
Ensuite, l’architecture des pipelines
Si V4.1 Flash tient vraiment ses promesses, il n’y a plus aucune raison d’utiliser V4 Pro pour la création de contenu. Le rapport qualité-prix devient imbattable. Ça simplifie la stack technique et réduit les points de défaillance.
Mais il y a un risque. Et il est de taille. Si DeepSeek force le routage sans que la qualité suive vraiment, tous ceux qui n’ont pas de protocole de validation vont se retrouver avec des articles dégradés sans s’en rendre compte. C’est pour ça que je partage mon plan avec vous. Même si vous n’utilisez pas exactement le même pipeline que moi, l’idée de tester avant de basculer en production reste universelle.
Si vous cherchez à choisir votre modèle d’IA en 2026, cette annonce rebat les cartes. DeepSeek redevient soudainement très compétitif face à la concurrence. Mais comme toujours, les annonces marketing ne valent pas un test en conditions réelles.
Les questions que vous vous posez
Puis-je continuer à utiliser V4 Pro après le 10 septembre ?
Techniquement oui, mais toutes vos requêtes seront automatiquement routées vers V4.1 Flash et facturées au tarif Flash. Vous n’avez pas le choix sauf si DeepSeek propose une option de désactivation du routage, ce qui n’est pas mentionné dans l’annonce officielle.
Comment optimiser les coûts avec les heures creuses et pleines ?
Les tarifs doublent pendant les heures de pointe. Planifiez vos batchs de création de contenu tôt le matin (avant 6h GMT+2) ou tard le soir pour bénéficier des tarifs off-peak. C’est particulièrement important si vous traitez des volumes importants.
Que faire si la qualité de V4.1 Flash ne me convient pas ?
Documentez précisément les problèmes rencontrés et contactez le support DeepSeek comme ils le suggèrent dans leur annonce. En attendant, vous pouvez envisager de basculer temporairement vers un autre modèle ou réduire votre cadence de publication le temps que DeepSeek corrige le tir ou sorte V4.1 Pro.
Le routage automatique affecte-t-il aussi les requêtes API directes ?
Oui, le routage s’applique à toutes les requêtes vers l’endpoint V4 Pro, que ce soit via l’interface web, l’API ou des intégrations tierces. Il n’y a pas de distinction selon le canal d’accès.
Faut-il modifier mon code pour utiliser explicitement V4.1 Flash ?
Non, DeepSeek gère le routage au niveau de leur infrastructure. Votre code peut continuer à appeler V4 Pro, la redirection sera transparente. Vous pouvez cependant mettre à jour vos endpoints pour pointer directement vers V4.1 Flash si vous préférez être explicite.
Voilà où j’en suis ce soir. Demain matin, test en conditions réelles. Je vous tiendrai informés des résultats, surtout si ça casse quelque part.
En attendant, si vous faites tourner des pipelines IA en production, ne prenez pas cette annonce pour acquise. Testez. Validez. Et seulement ensuite, basculez en production. C’est peut-être moins sexy que de sauter sur la nouveauté immédiatement, mais c’est comme ça qu’on évite les catastrophes silencieuses qui plombent un blog pendant des mois avant qu’on s’en rende compte.
Article utile ? Dites-le à Google. Ajoutez ce blog à vos sources préférées : un clic, et vous le retrouverez dans vos recherches (et l’AI Mode) au lieu du contenu recyclé par des robots. C’est votre façon de reprendre le contrôle sur ce que vous lisez.
Et si vous avez aimé, partagez (c’est le meilleur coup de pouce pour un blog indépendant qui publie sans algorithme ni sponsor déguisé).
Un clic, gratuit. Nécessite d’être connecté à votre compte Google.
DeepSeek sortira officiellement V4.1 Flash le 10 septembre. Je prépare déjà un article sur les implications pour les écrivains numériques.
Ce changement de prix annule un peu la dernière hausse, mais quand on additionne toutes les augmentations précédentes, le tarif de base + cache rend le tout beaucoup plus cher qu’avant. Je vais retester après ce changement. (J’utilisais Flash standard, pas Pro, comme sous-agent de codage, pas comme modèle de raisonnement. J’étais assez déçu du résultat.)
Une version de test qui expire demain, et on parle déjà du retour de DeepSeek ? Le multimodale natif à ce prix mérite qu’on s’y intéresse. J’attendrai la version finale pour me prononcer.
Yo ! Super contenu, j’ai partagé sur mes réseaux.
Apparemment, OpenDesign prépare un mode scène 3D avec un backend Blender pour la modélisation, les textures et les shaders. Avec un compilateur qui servirait de « world-linter » pour détecter les problèmes graphiques (comme le z-fighting). Intéressant pour les créations littéraires interactives.
Salut, suis-je le seul à ne trouver ce modèle nulle part ? Peut-être que je ne cherche pas au bon endroit.
J’ai testé Flash GA et ce n’est pas si bon. DeepSeek disait que c’était similaire à Opus 4.8, mais il y a une grande différence entre les deux. Comme entre un roman et sa version abrégée.
DeepSeek prévoit de sortir V4.1 Flash vers le 10 septembre 2026. Les premiers tests montrent qu’elle serait plus performante que la V4 Pro, avec un meilleur rapport qualité-prix. Hâte de voir ça sur nos Raspberry Pi !
On ne voit pas bien quel lancement de fusée est celui de DeepSeek, mais la course à l’IA est passionnante à suivre !
Ce gars est presque un agent IA dans le cloud, c’est impressionnant ! Ça me rappelle les promesses de la littérature cyberpunk.
Tu pourrais partager comment tu as généré le modèle 3D ? C’était avec Three.js et une image de référence ?
Toutes les données sont enregistrées pour l’entraînement. (Demande à ton IA.) Un peu flippant, mais fascinant pour la recherche.
On attend DeepSeek V5 Astra avec impatience, ça risque d’être une révolution pour les projets open-source.
Est-ce que la version benchmark sortira sur ce modèle ? J’aimerais faire des tests comparatifs pour le blog.
À 5:16, il remarque même que les ponts finissent dans l’eau. Une belle métaphore pour notre rapport à la technologie.
J’aimerais que les modèles open-source soient moins bavards dans leur raisonnement, et plus proches des modèles fermés qui ont un raisonnement plus orienté vers l’action, plutôt que le raisonnement avant l’appel d’outils. Un vrai débat pour les développeurs !
Super vidéo sur les derniers modèles ! J’ai particulièrement aimé le test du Qwen 3.8 Max et du DeepSeek V4 Flash. Ça donne des idées pour mes prochains articles.
Je suis impressionné par le nombre de langues supportées en traduction. Parfait pour mon blog sur les littératures du monde.
Est-ce que DeepSeek va utiliser la profondeur récurrente (ou les transformeurs en boucle) que GPT-6 Astra utilise ? Ce serait intéressant pour les applications embarquées.
Article de ouf, comme toujours ! Continue comme ça, ça nourrit ma veille technologique. Des Geeks Et Des Lettres in force !
Premier ici pour voir le GOAT du contenu IA. Ça va faire des étincelles sur le blog !
Est-ce que c’est rapide à cause d’une faible utilisation en ce moment, ou est-ce vraiment plus rapide ? La question mérite d’être creusée.
Il faudrait vraiment pousser les tests plus loin pour voir les limites de ce modèle. C’est comme pour un bon livre, on n’en découvre la profondeur qu’en le lisant jusqu’au bout.