
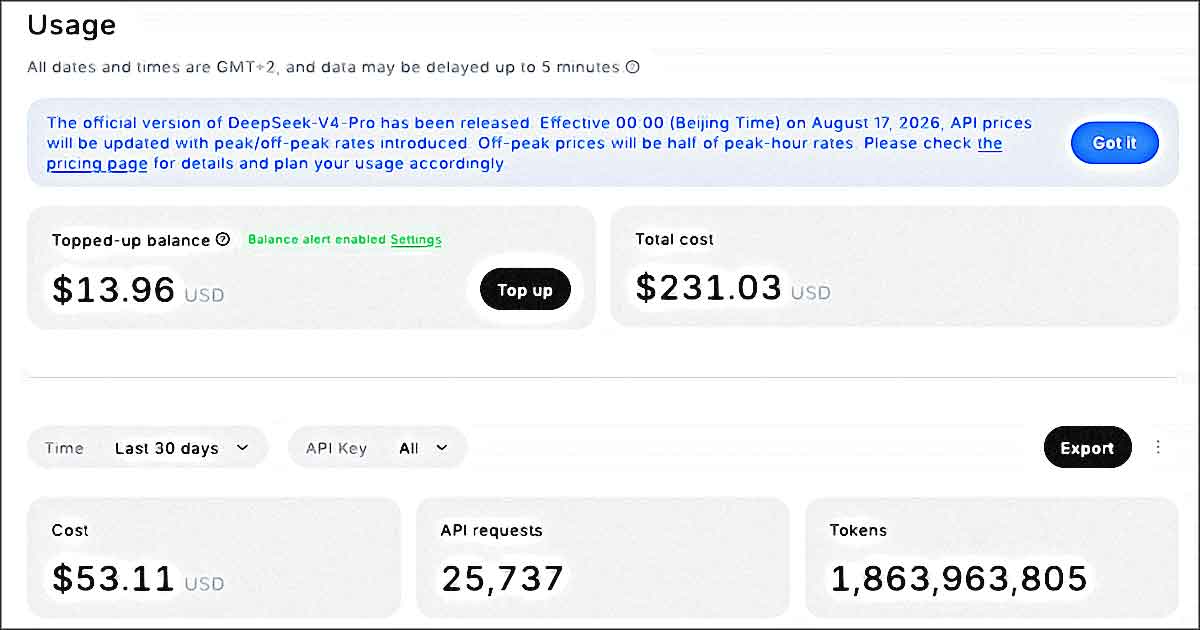
Le 16 août 2026, DeepSeek V4 Pro change sa tarification. Le prix de l’output bondit de $0.87 à $1.98 en heure creuse, et jusqu’à $3.96 en heure de pointe. Vous lisez bien. Le carburant de nos automations vient de subir une hausse d’un facteur 2,3, même en dehors des heures d’affluence.
En biologiste qui scrute son microscope, j’observe mon pipeline SEO. Il ressemble à une fourmilière où chaque appel d’API est une ouvrière. Elle transporte son fardeau de tokens. Aujourd’hui, le gardien de l’entrée exige un péage plus lourd pour chaque passage. Si nous ne changeons pas notre façon de nourrir l’essaim, la facture va exploser.
La mutation tarifaire de l’essaim numérique
Le rythme des heures de pointe
La nouvelle règle divise la journée en deux territoires distincts.
- Le territoire de l’abondance, dit off-peak, où le carburant coûte la moitié du prix fort.
- Et le territoire de la pénurie, le peak, où le tarif double par rapport à l’heure creuse.
Il faut adapter les cycles de l’essaim à cette horloge biologique. Les heures d’activité intense de l’API correspondent à des plages horaires bien précises en heure de Paris.
- Heures peak : 03h à 06h et 08h à 12h
- Heures off-peak : 12h à minuit, 00h à 03h, 06h à 08h
L’impact sur la facture globale n’est pas une simple multiplication par deux. Comme nous renvoyons le HTML de l’article à chaque passe, les tokens d’entrée dominent le volume. Quand on mélange les coûts d’entrée et de sortie, la hausse réelle se chiffre autrement.
| Créneau de lancement | Multiplicateur sur la facture actuelle |
|---|---|
| Off-peak (12h à minuit, 6h à 8h) | x 1,7 |
| Peak (8h à 12h, 3h à 6h) | x 3,5 |
Pour un batch complet de 171 articles en mise à jour, la différence de créneau représente une économie massive.
Lancer les ouvrières l’après-midi coûtera environ 87 dollars. Les lancer le matin coûtera 178 dollars. La seule décision qui compte est de planifier les batchs en mode malin, jamais entre 8h et 12h.
Le métabolisme caché du cache contextuel
Pour survivre à cette inflation tarifaire, il faut comprendre comment la fourmilière digère ses informations. DeepSeek garde en cache disque la partie initiale de nos prompts. Si le début d’un nouveau prompt est identique au précédent, cette section n’est pas recalculée. Elle est facturée au tarif cache hit, soit 30 fois moins cher que le tarif plein.
C’est un mécanisme automatique. Vous n’avez rien à coder pour l’activer. Mais la règle d’or de la biologie de l’API est stricte. Ce qui est stable va au début du prompt. Ce qui change va à la fin.
Le cache ne fait pas de correspondance approximative. Il travaille par unités de préfixe qui doivent correspondre entièrement au caractère près. Un seul espace qui change invalide tout le bloc précédent. Si vous insérez un timestamp ou un titre d’article au début de votre prompt system, vous détruisez la mémoire de la colonie à chaque appel.
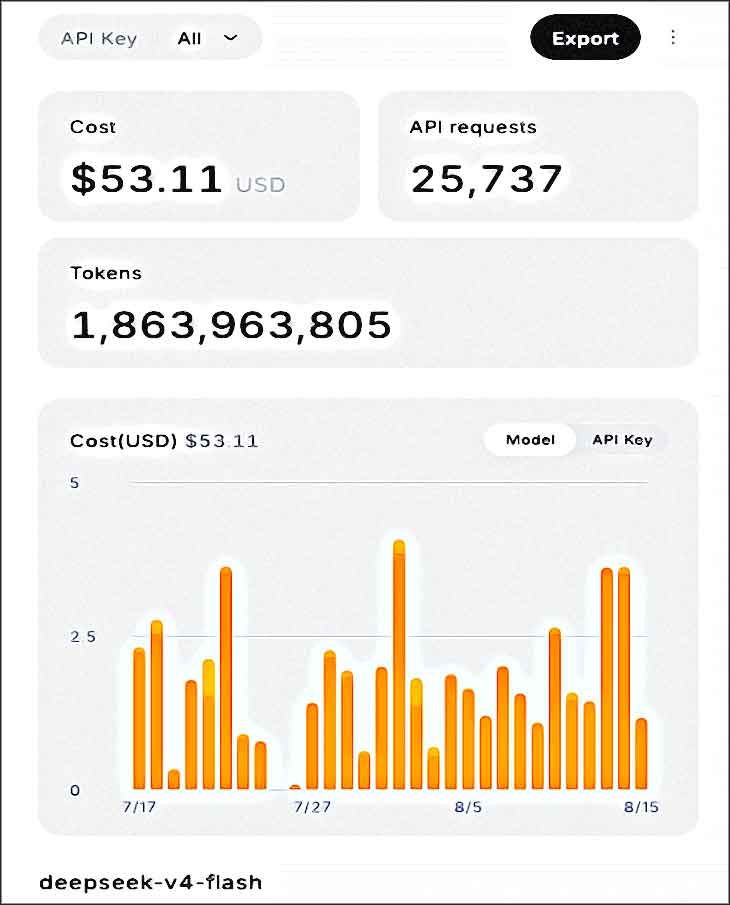
Ici la plate-forme officielle de la clé api Deepseek
L’autopsie d’un pipeline sous perfusion
La fuite de tokens invisibles
J’ai remonté toute la chaîne de mon orchestrator jusqu’au client DeepSeek. Le diagnostic est clair. L’ordre des appels est correct, mais incomplet. Pour les grosses passes de traitement, le message system est vide. Tout le contenu, incluant les instructions et l’article, part dans le message user.
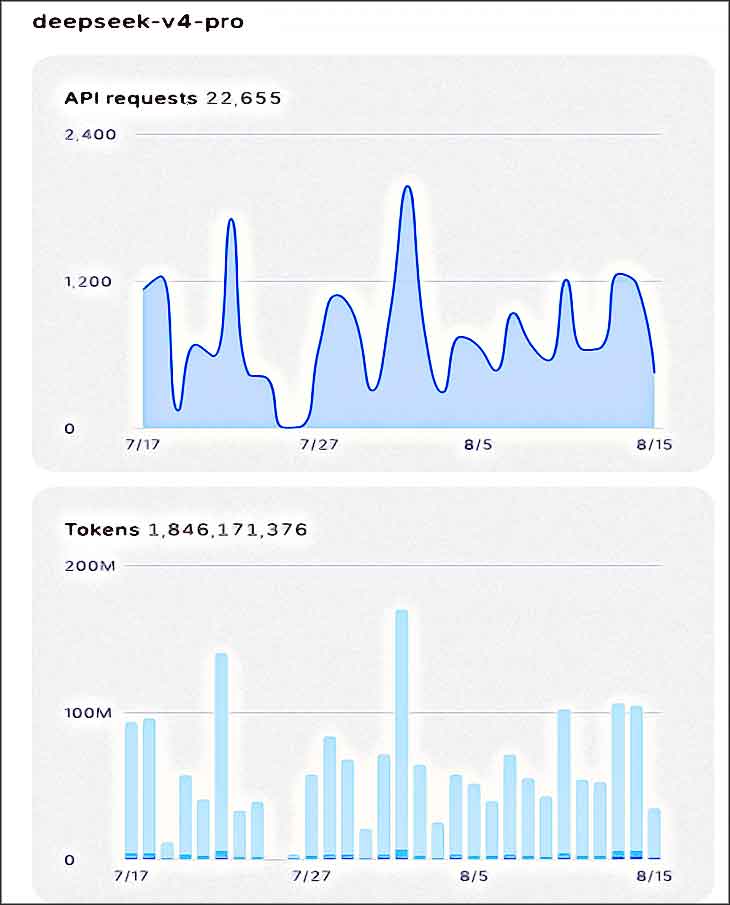
Le Style Guide et la bio de l’auteur sont injectés au milieu du prompt via un placeholder. Ils ne sont jamais en préfixe stable. Conséquence directe, ces 4200 tokens stables sont refacturés au tarif plein à chaque appel, pour chaque passe et pour chaque article.
| Élément du prompt | Volume de tokens | Statut actuel de facturation |
|---|---|---|
| Style Guide core | ~2 000 | Refacturé plein tarif x1000 |
| Bio de l’auteur | ~2 200 | Refacturé plein tarif x1000 |
Sur un batch complet, ce sont environ 4,2 millions de tokens qui partent en fumée. À la différence du tarif cache miss et cache hit, cela représente près de trois dollars gâchés par batch complet, juste pour ces deux blocs mal positionnés.
Le dilemme du génome fragile
La peur de briser la voix
La solution logique consisterait à déplacer le Style Guide et la bio vers le message system. C’est un levier quasi gratuit d’un point de vue développement. Mais mon instinct de biologiste me met en garde. Le vrai risque n’est pas technique, il est qualitatif.
Faut-il déplacer le Style Guide pour économiser des tokens
Non. Le gain financier est faible, environ 2.70 dollars par batch complet. Le risque de perdre la voix de l’auteur est bien trop grand. Il vaut mieux garder l’état actuel et préserver la qualité éditoriale plutôt que de risquer une micro-régression de l’adhérence au ton.
Déplacer des instructions du rôle user vers le rôle system change la façon dont le modèle les pondère.
Les modèles traitent le rôle system comme une consigne de niveau supérieur. Sur des prompts finement calibrés pour l’anti-détection IA, un repositionnement peut modifier l’adhérence au ton de manière subtile. C’est le genre de micro-régression qui peut ruiner un workflow déjà fragile.
Le pipeline marche. La structure de base est correcte, avec les instructions en tête et le contenu variable à la fin. Ne rien changer est une décision parfaitement rationnelle. Le gâchis identifié représente 2 à 3% de la facture totale. Le ratio risque et bénéfice ne justifie pas de modifier l’ADN du système aujourd’hui.
Le trajet de l’ouvrière et la rafale séquentielle
Les passes successives du butinage
Pour bien comprendre l’enjeu, il faut observer le trajet d’une seule ouvrière. Dans mon pipeline, chaque article subit 6 passes successives. De P0 à P5, l’insecte numérique repart au nid, dépose son pollen, et revient avec une nouvelle instruction. Ce comportement en rafale est la clé de voûte du système.
Ici, le cache contextuel prend tout son sens biologique. Au 2ème passage sur un même article, l’API reconnaît le préfixe. Elle ne recalcule pas le bloc d’instructions de base. La machine se contente de lire la nouveauté. Elle facture cette partie au tarif préférentiel, 30 fois moins cher que le tarif plein.
Mais la mutation tarifaire du 16 août impose de recalibrer nos estimations
Les chiffres exacts de la colonie montrent l’impact direct sur le métabolisme financier. Voici la projection pour la mise à jour et la création d’articles.
| Opération (10 articles) | Avant le 17/08 | Coût Off-peak | Coût Peak |
|---|---|---|---|
| Estimation basse ($0.055/article) | $0.55 | $0.95 (+$0.40) | $1.95 (+$1.40) |
| Estimation haute ($0.30/article) | $3.00 | $5.10 (+$2.10) | $10.50 (+$7.50) |
Sur un petit échantillon, la différence paraît anodine. Un dollar face à deux dollars. Mais le véritable test de résistance se mesure sur un volume critique.
Pour un batch complet de 171 articles en mise à jour globale, l’heure de pointe fait grimper la facture à 178 dollars. En heure creuse, elle plafonne à 87 dollars. C’est un facteur de survie pour le blog.
Sur mon blog : 2 blogs, 3 620 articles, 1 agent IA : mon bilan SEO de juillet 2026
Anatomie d’un prompt optimisé
La structure immuable du message
Pour comprendre comment payer moins cher, il faut observer comment DeepSeek mémorise l’information.
L’API fonctionne comme une ouvrière qui reconnaît l’odeur de la reine. Si vous lui envoyez le même début de message, elle le mémorise et vous facture cette partie 30 fois moins cher. C’est le principe du cache contextuel.
Mais cette mémoire est fragile. Si vous inversez l’ordre de vos instructions, l’ouvrière ne reconnaît plus l’odeur de la reine. La reconnaissance échoue et vous payez le plein tarif pour tout le volume envoyé.
Ce système ne fait pas de correspondance approximative. Il exige que le début de votre message soit identique au caractère près. Un simple espace modifié anéantit toute la chaîne de mémoire. L’ordre des mots n’est pas une suggestion, c’est une nécessité vitale.
Il existe 2 façons de construire votre requête. L’une nourrit la mémoire de la machine, l’autre la détruit. Voici la cartographie exacte de ce que vous devez envoyer.
- Structure saine. Les instructions fixes et les consignes de style placées en tout premier. Le contenu de l’article ajouté ensuite. La tâche précise à exécuter collée tout à la fin.
- Structure toxique. Le contenu de l’article placé en premier, les instructions placées après. Zéro mémoire activée, vous payez le prix fort pour tout le volume.
Les limites de la mémoire artificielle
Une économie restreinte aux données entrantes
Cette mémoire magique a une limite anatomique. Elle ne s’applique qu’à ce que vous envoyez à l’IA, comme vos instructions ou votre texte source. Le texte que l’IA produit en sortie, l’article final, se paie toujours au tarif fort. Que vous utilisiez le cache ou non, la création de texte nouveau coûte 1.98 dollar en heure creuse et 3.96 dollars en heure de pointe.
De plus, le contenu de votre article change à chaque étape de traitement. Il ne sera jamais mémorisé par le cache. Il constitue la partie variable et coûteuse de l’équation. Il ne faut donc pas espérer une facture divisée par trente.
La réduction attendue tourne autour de 10 à 20% sur la partie envoyée. Comme l’envoi représente environ la moitié de la facture globale, le gain réel se situe entre 5 et 10%. C’est un sauvetage réel, pas un miracle mathématique.
Pourquoi le facteur de hausse varie-t-il entre 1,7 et 3,5 ?
Le facteur dépend de la part de mémoire que vous utilisez. Si votre code sollicite peu le cache, la hausse suit les multiplicateurs de base. Mais si votre mémoire était déjà très sollicitée, la hausse sera plus sévère. Le coût des éléments mémorisés passe de 0,0036 dollar à 0,022 dollar, soit une multiplication par six.
La mémoire de la ruche et la dégradation des phéromones
L’évaporation naturelle du marqueur
Un mécanisme biologique implique toujours une dégradation. Les phéromones de la ruche ne durent pas éternellement. Le cache disque de DeepSeek fonctionne sur un mode best-effort. Il expire après quelques heures, parfois quelques jours. L’information finit par s’évaporer de la mémoire de la machine.
Cette limite physiologique impose une discipline de groupe. Le gain est maximal quand vous traitez les passes en rafale rapprochée. Si vous lancez la passe P1 le matin et la passe P4 le lendemain soir, le cache aura disparu. Vous repartirez de zéro, avec un tarif plein pour recalculer le préfixe.
Vous savez déjà lequel vous correspond ? Accès direct :
Compétences IA 2026 : la feuille de route qui change tout
Mon architecture actuelle fonctionne déjà en batch séquentiel. Les articles sont traités les uns après les autres, sans temps mort. C’est exactement le comportement attendu pour préserver la mémoire de la colonie. La stratégie d’observation doit juste s’assurer que cette dynamique de groupe se maintient dans le temps.
Le protocole d’observation du biologiste
Le relevé de terrain sur le compteur
Pour valider ces hypothèses, il faut installer un dispositif de mesure. DeepSeek renvoie 2 champs précis dans la réponse JSON.
- Le champ prompt_cache_hit_tokens indique les tokens qui ont tapé dans le cache.
- Le champ prompt_cache_miss_tokens liste les tokens facturés au tarif plein.
Mon client actuel ne lit que le contenu généré. Il ignore ces champs de consommation. C’est comme observer une fourmilière sans compter les ouvrières qui entrent et sortent. On voit l’activité, mais on ignore le rendement exact.
Ajouter cette lecture dans le code est l’équivalent d’une pose de capteur.
| Capteur de mesure | Variable lue | Objectif du relevé |
|---|---|---|
| Compteur de hits | prompt_cache_hit_tokens | Mesurer la mémoire active de la ruche |
| Compteur de miss | prompt_cache_miss_tokens | Identifier les fuites de tokens plein tarif |
Pourquoi le relevé du compteur est-il suffisant pour le moment
L’ajout de ce logging ne modifie ni le prompt, ni le comportement du modèle. C’est une opération d’observation pure. Une fois les données récoltées sur un batch complet, nous pourrons calculer le taux réel de cache hit. Ce chiffre nous dira si le déplacement du Style Guide vaut vraiment la peine d’être tenté.
La check-list de survie de l’écosystème
Les gestes qui ne coûtent rien
La mutation tarifaire du 16 août impose de nouveaux réflexes.
- Le premier est purement temporel. Il faut bannir les lancements de batchs entre 8h et 12h, heure de Paris. C’est la période de jeûne où le péage de l’API est au maximum. Planifier le lancement l’après-midi ou le soir divise la hausse par deux.
- Le deuxième geste est structurel. Il faut conserver l’ordre immuable du prompt. Les instructions fixes et stables au début. Le HTML variable et la tâche spécifique à la fin. Cette règle de base garantit que le mécanisme de cache pourra s’enclencher naturellement dès la deuxième passe.
- Le troisième geste est l’observation. Installer le logging du compteur de tokens sans toucher au reste du code. Rassembler les données sur un cycle complet de mise à jour. Regarder la colonie travailler sans intervenir. C’est la seule façon de prendre une décision éclairée pour l’avenir.
Le véritable levier financier n’est pas dans une optimisation complexe du code. Il réside dans le respect des rythmes biologiques de l’API.
- L’heure creuse est notre alliée.
- La rafale séquentielle est notre stratégie.
- L’observation est notre bouée de sauvetage.
Mon avis sur la résilience
Face à ce changement de climat tarifaire, la tentation est forte de modifier l’ADN du workflow pour s’adapter. On pourrait vouloir déplacer des scripts, changer la structure des prompts, bousculer les habitudes de la machine. Mais la biologie nous enseigne la prudence.
Une mutation précipitée détruit souvent ce qu’elle cherche à sauver. Le pipeline actuel est un organisme fragile, mais parfaitement fonctionnel.
- Sa voix,
- son ton,
- son anti-détection IA sont le fruit d’un long processus de sélection naturelle éditoriale.
On ne modifie pas la chimie d’un insecte pollinisateur sous prétexte que le nectar devient plus rare.
Le gain escompté en repositionnant le Style Guide est dérisoire face au risque de perdre cette voix unique. Trois dollars d’économie par batch complet ne justifient pas de mettre en péril l’identité de toute la production. Le pipeline marche, la structure de base est saine, et le carburant s’active déjà naturellement sur les préfixes communs.
La nature a choisi la voie de l’adaptation comportementale plutôt que la mutation génétique immédiate. C’est exactement la stratégie que je recommande pour votre workflow.
- Décalez vos cycles de butinage vers l’après-midi.
- Observez les compteurs de tokens.
- Laissez l’organisme s’habituer à son nouvel environnement sans le brusquer.
Le 16 août 2026 marquera le début d’une nouvelle ère pour l’essaim numérique. Les prédateurs financiers seront plus actifs le matin. L’après-midi et la soirée deviendront notre sanctuaire d’exploitation.
En respectant cette horloge biologique, la colonie continuera de produire son miel éditorial, sans que le gardien de l’API ne vide nos réserves. La survie du blog ne dépend pas d’une réécriture hasardeuse du code, mais d’une simple discipline du temps.
Article utile ? Dites-le à Google. Ajoutez ce blog à vos sources préférées : un clic, et vous le retrouverez dans vos recherches (et l’AI Mode) au lieu du contenu recyclé par des robots. C’est votre façon de reprendre le contrôle sur ce que vous lisez.
Et si vous avez aimé, partagez (c’est le meilleur coup de pouce pour un blog indépendant qui publie sans algorithme ni sponsor déguisé).
Un clic, gratuit. Nécessite d’être connecté à votre compte Google.