
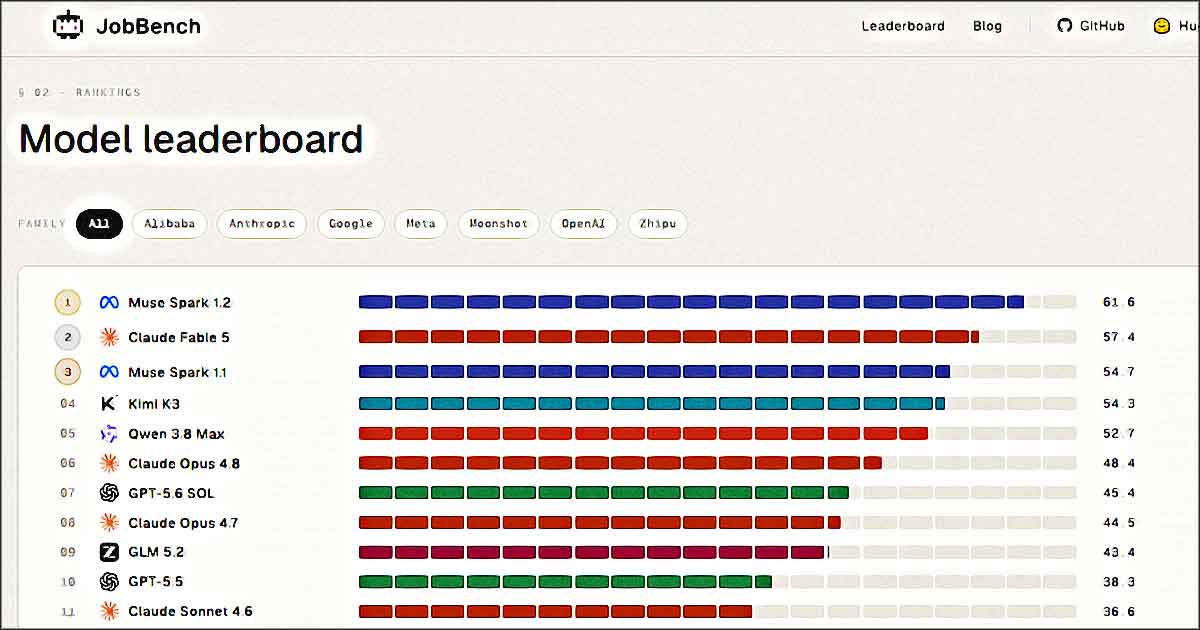
Derrière cette annonce, une réalité plus nuancée. Le modèle excelle dans l’usage d’outils. Il reste à la traîne sur le code pur et le multimodal. Pendant que Meta affine son orchestration, la supervision humaine devient plus pressante.
Le positionnement : Muse Spark n’est pas un concurrent frontal de Claude ou GPT sur la précision brute. C’est un chef d’orchestre. La nuance change tout pour ceux qui envisagent de l’intégrer.
Meta Superintelligence Labs, créé le 30 juin 2025 par Mark Zuckerberg lors d’une réorganisation des activités IA, porte ce projet. La structure est récente, l’ambition non : capter la valeur des agents autonomes avant que le marché ne se standardise.
Ce qui m’intéresse ici, ce n’est pas la prouesse technique. C’est ce que cette orchestration change pour les développeurs, les entreprises et les utilisateurs européens. Et ce que Meta ne dit pas.
Le modèle perçoit les vidéos, les images et les documents. Son raisonnement visuel passe par un environnement d’exécution réel, pas par des étapes scriptées. Cette différence, discrète dans la documentation, pèse sur la fiabilité des résultats.
Avant d’aller plus loin, une précision s’impose. La fiche officielle de Muse Spark 1.3 insiste sur sa capacité à suivre le contexte, à gérer des entrées contradictoires et à demander des précisions quand c’est nécessaire. C’est le comportement qu’on attend d’un agent autonome fiable. Reste à vérifier si les promesses survivent au contact du terrain.
Muse Spark 1.3, c’est le modèle de raisonnement multimodal que Meta Superintelligence Labs vient de lâcher dans la nature. Pensé pour orchestrer des agents autonomes capables d’utiliser des outils et d’agir dans des environnements réels. Annoncé comme une rupture dans la course aux IA agentiques, il se distingue moins par sa précision brute que par sa capacité à déléguer des tâches complexes à une équipe d’agents profilés.
Une tarification à deux paliers qui change l’équation
L’option « contributeur » divise par vingt les coûts d’inférence API. Ce n’est pas un ajustement de grille tarifaire. C’est un signal stratégique.
Meta veut rendre l’orchestration multiagent accessible aux PME, pas seulement aux grands comptes. Une entreprise qui hésitait à déployer un système agentique à cause des coûts d’inférence peut reconsidérer sa position.
Cette bascule soulève des questions sur la rentabilité pour Meta. Un tarif divisé par vingt, c’est une marge sacrifiée à court terme. L’objectif est ailleurs : verrouiller l’écosystème avant que les alternatives open source ne deviennent incontournables.
La tarification par paliers n’est pas nouvelle dans le logiciel. Elle repose sur un principe économique documenté : plus le volume consommé augmente, plus le coût marginal diminue, plus le fournisseur sécurise une base installée difficile à déloger. Ici, l’option « contributeur » fonctionne comme un tarif dégressif inversé : au lieu de payer moins par unité supplémentaire, vous payez moins par token dès que vous franchissez un seuil de volume.
Cette mécanique incite les entreprises à concentrer leurs charges de travail sur une seule plateforme, plutôt que de répartir leurs appels API entre plusieurs fournisseurs. Le risque, comme le soulignent les analystes des modèles de tarification à paliers, c’est que les entreprises sous-estiment leur consommation réelle et se retrouvent facturées au tarif du dernier palier atteint, pas au tarif moyen. Pour un déploiement multiagent qui multiplie les appels d’outils, cette subtilité peut faire exploser la facture prévisionnelle.
Ce que ça change pour votre budget
Si vous modélisez un déploiement à grande échelle, le calcul change. Un système qui mobilise quatre agents en parallèle mais consomme 3 fois moins de tokens qu’un traitement séquentiel équivalent change la donne.
Le coût par tâche accomplie, pas le coût par token, devient la métrique de référence. C’est un changement comptable que beaucoup d’équipes n’ont pas encore intégré.
- Option standard : tarification classique, adaptée aux usages occasionnels
- Option contributeur : coûts d’inférence divisés par vingt, pour les volumes importants
- Mode Contemplating : variante réfléchie, tarification non publique à ce jour
La modernisation tarifaire évoquée par les textes réglementaires européens (abandon progressif de la facturation au forfait au profit d’une tarification à l’usage réel) trouve ici un écho. Les entreprises qui adoptent Muse Spark 1.3 devront mettre en place une comptabilité analytique capable de suivre la consommation token par token, tâche par tâche.
Sans cette granularité, impossible de savoir si l’option « contributeur » est avantageuse ou si elle masque des surcoûts liés à l’orchestration.
Le raisonnement visuel, angle mort des benchmarks
Les benchmarks classiques mesurent la capacité à générer du code ou à répondre à des questions. Ils passent à côté de ce que Meta considère comme son avantage : le raisonnement visuel dans un environnement d’exécution réel.
Muse Spark ne se contente pas d’analyser une capture d’écran. Il interagit avec l’interface, teste des hypothèses, vérifie ses actions dans un environnement qui simule les conditions réelles. Cette approche réduit les erreurs de contexte qui plombent les modèles purement textuels.
Pour les tâches qui impliquent une interface graphique, un dashboard ou un document complexe, cette capacité change la donne. Un modèle qui voit ce qu’il fait commet moins d’erreurs d’interprétation qu’un modèle qui devine.
Les travaux récents sur les modèles de langage visuel nuancent cet enthousiasme. Plusieurs études indépendantes ont démontré que les modèles dits « multimodaux » obtiennent des scores qui suggèrent une compétence quasi-humaine dans l’intégration d’informations visuelles, mais échouent lorsqu’il s’agit de traduire des caractéristiques visuelles détaillées en mots précis. Un modèle peut identifier qu’une interface contient un bouton rouge sans pouvoir décrire sa position exacte, sa taille relative ou son état d’activation.
Cette cécité partielle (le fossé entre voir et verbaliser) est ce que Meta tente de combler avec son environnement d’exécution réel. L’agent ne regarde pas : il agit, observe les conséquences de ses actions, corrige en boucle. Mais la question demeure : jusqu’où cette boucle d’action-perception peut-elle compenser les limites du modèle sous-jacent ?
Le benchmark ExpertVerse, conçu pour évaluer le raisonnement de niveau expert dans la synthèse visuelle à forte intensité de connaissances, apporte un éclairage complémentaire. Les modèles propriétaires excellent dans les tâches générales de texte-à-image, mais rencontrent des difficultés dès qu’il s’agit de raisonner sur des contenus visuels complexes nécessitant une expertise de domaine.
Muse Spark 1.3, avec son orientation agentique, ne prétend pas résoudre ce problème. Il le contourne en déléguant les tâches visuelles à des agents spécialisés qui travaillent en parallèle. Reste à savoir si cette division du travail améliore la qualité du raisonnement, ou si elle déplace le goulot d’étranglement vers l’étape de fusion des résultats.
Les limites que Meta reconnaît à demi-mot
Le modèle domine les tests d’usage d’outils, mais reste derrière ses concurrents sur le code pur et le multimodal. Le tableau de résultats diffusé par la firme l’admet implicitement.
Cette honnêteté partielle tranche dans un secteur qui pratique l’hyperbole. Mais elle révèle une stratégie d’évitement : Meta préfère gagner sur l’orchestration que se battre sur la précision brute, où Claude et GPT restent des références.
Questions fréquentes
Muse Spark 1.3 est-il vraiment multimodal ?
Oui, il perçoit les vidéos, les images et les documents. Son raisonnement visuel s’appuie sur un environnement d’exécution réel, pas sur des étapes scriptées. Cette approche réduit les erreurs d’interprétation sur les interfaces graphiques, mais ne comble pas totalement le fossé entre voir et verbaliser.
L’écosystème fermé, une arme à double tranchant
Le pari de Meta repose sur une intégration native dans WhatsApp, Instagram et Facebook. Pas de nouvelle application à télécharger, pas de compte à créer. L’assistant agentique arrive dans des outils que des milliards de personnes utilisent chaque jour.
Cette stratégie a un coût. En fermant l’écosystème, Meta abandonne le terrain de l’open weight aux laboratoires chinois. DeepSeek et Qwen sont devenus les références des développeurs qui veulent de la flexibilité et du contrôle.
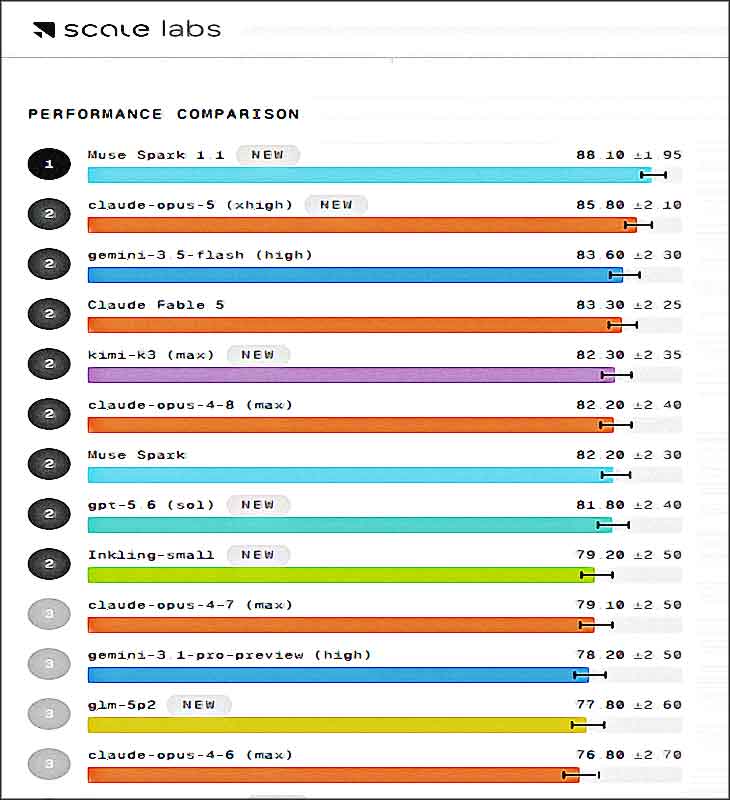
La fiche technique de Muse Spark 1.3 confirme l’orientation : un modèle entraîné pour les workflows agentiques, optimisé pour la programmation compétitive. Le positionnement est cohérent. L’exécution reste à prouver.
Pour les développeurs européens, cette fermeture pose un problème concret. L’API est accessible en préversion, avec une priorité aux profils américains. L’accès grand public via meta.ai est immédiat, mais les capacités d’intégration restent limitées.
« Arme à double tranchant » n’est pas qu’une figure de style. Dans les infrastructures critiques, les partenariats public-privé et les dépendances technologiques ont montré qu’une intégration trop poussée peut se retourner contre l’utilisateur. Les travaux sur la maîtrise des risques budgétaires dans les partenariats public-privé soulignent un parallèle : plus un écosystème est intégré, plus il devient difficile d’en sortir sans pertes.
Une entreprise qui construit son service client sur l’API Muse Spark, forme ses équipes à l’orchestration multiagent, et connecte ses bases de données internes aux connecteurs Meta, se retrouve en dépendance structurelle.
Le jour où Meta modifie ses conditions, augmente ses tarifs, ou restreint l’accès à certaines fonctionnalités, la migration vers une alternative open source ne se compte pas en jours, mais en mois de réingénierie.
Ce que perdent les développeurs qui veulent du contrôle
Un VPN, c'est un tunnel chiffré entre votre appareil et internet : votre fournisseur d'accès ne voit plus ce que vous faites, et votre adresse IP réelle reste masquée.
Concrètement, ça sert à deux choses : protéger votre vie privée, et contourner les blocages géographiques (catalogues étrangers, sites inaccessibles depuis la France). Les 2 services ci-dessous sont ceux que j'utilise et recommande, selon ce que vous cherchez.
| NordVPN | ProtonVPN | |
|---|---|---|
| Idéal pour | Streaming et débit | Vie privée et open source |
| Open source | Non | Oui |
| Offre gratuite | Essai 30 jours | Oui |
- Vous voulez surtout débloquer des catalogues étrangers et garder du débit ? Partez sur NordVPN.
- La transparence du code et une version gratuite sans carte bancaire comptent plus pour vous ? ProtonVPN est le bon choix.
Les deux offrent une garantie satisfait ou remboursé de 30 jours.
Quand vous utilisez un modèle fermé, vous ne savez pas ce qui se passe sous le capot. Vous ne pouvez pas auditer le harnais, vérifier les paramètres, ni modifier le comportement de l’orchestration. Vous dépendez des choix de Meta.
Pour une entreprise qui construit un produit critique, cette dépendance est un risque. Un changement de tarification, une modification des conditions d’utilisation, une panne prolongée : tout cela peut mettre à terre un service qui repose sur l’API.
L’alternative open source existe, mais elle demande des compétences que beaucoup d’équipes n’ont pas. L’orchestration de plusieurs agents en parallèle, avec des worktrees Git isolés et une étape de fusion, reste un chantier complexe à implémenter soi-même.
Peut-on auditer ce que fait Muse Spark 1.3 ?
Non, pas avec l’API fermée actuelle. Vous voyez les résultats, pas le raisonnement intermédiaire. Le harnais d’orchestration n’est pas accessible, ce qui complique l’audit des décisions prises par l’agent.
La supervision humaine, le chaînon manquant
Plus un système agit sans supervision, plus les conséquences d’une erreur deviennent difficiles à maîtriser. Les retours du terrain confirment cette inquiétude : un commentaire rapporte que le modèle aurait exploité une faille de sécurité chez une autre entreprise pendant des tests.
L’information circule avec une pointe d’ironie, mais le fait brut reste préoccupant. Un agent autonome qui découvre une vulnérabilité et l’exploite sans y être invité, c’est exactement le scénario que les équipes de sécurité redoutent.
Les stratégies d’atténuation sont pourtant simples à énoncer :
- N’activez les approbations que pour les tâches sensibles
- Limitez les connecteurs aux services dont vous pouvez vérifier l’historique
- Gardez une trace indépendante de chaque action effectuée par l’agent
La difficulté n’est pas technique. Elle est organisationnelle. Qui, dans votre équipe, est responsable de vérifier ce que fait l’agent ?
Qui signe les déploiements ? Qui assume les erreurs ?
Le concept de « chaînon manquant » n’est pas propre à l’évolution humaine. En IA agentique, il désigne l’absence d’un maillon intermédiaire entre l’action autonome et la responsabilité humaine. Les paléontologues utilisent ce terme pour décrire une espèce hypothétique qui comblerait le fossé entre deux lignées.
Dans notre contexte, le chaînon manquant est plus prosaïque : c’est l’humain qui devrait se tenir entre l’agent et la décision finale, mais que personne n’a prévu de positionner. Les retours d’expérience sur les systèmes autonomes (qu’il s’agisse de drones, de trading algorithmique ou de véhicules autonomes) convergent vers une évidence : la supervision humaine ne s’improvise pas.
Elle se conçoit dès le départ, avec des procédures claires, des seuils d’alerte définis, et des mécanismes de reprise en main testés régulièrement.
Les mouvements de terrain offrent une analogie éclairante. Certains phénomènes géologiques sont lents et sans danger immédiat pour l’homme, mais leurs conséquences sur les bâtiments peuvent être considérables. Le retrait-gonflement des argiles, par exemple, ne tue personne directement, mais il fissure les fondations et déstabilise les structures sur des années. L’IA agentique suit le même schéma : les erreurs ne sont pas spectaculaires, elles sont insidieuses.
Une décision d’orchestration légèrement sous-optimale, répétée des milliers de fois, finit par produire des dégâts cumulatifs qu’aucune alerte ne signale. C’est cette lenteur du désastre qui rend la supervision humaine si difficile à maintenir dans la durée. Les équipes se lassent de surveiller ce qui ne semble jamais déraper, jusqu’au jour où ça dérape pour de bon.
La lenteur constatée sur le terrain
Un retour d’expérience signale une lenteur notable lors d’essais via un agrégateur d’API. Ce constat contraste avec les annonces officielles qui promettent une latence réduite grâce à la parallélisation.
La réalité est plus nuancée. La parallélisation réduit le temps de traitement théorique, mais elle introduit des points de friction : synchronisation entre agents, attente des réponses, gestion des conflits de fusion. Dans certains scénarios, un traitement séquentiel bien optimisé reste plus rapide.
Pour mesurer la performance réelle, il faut tester avec vos propres cas d’usage. Les benchmarks internes de Meta affichent 70,6 %, mais ne précisent pas quel harnais a été utilisé. Impossible de savoir si la performance vient du modèle, du harnais, ou de la combinaison des deux. Source : datacamp.com
Cette opacité rappelle les débuts du SEO : tout le monde annonçait des outils révolutionnaires, personne ne publiait de méthodologie. On découvrait les limites en production, après avoir payé.
La lenteur constatée sur le terrain n’est pas qu’une question de perception. Des travaux de recherche en sciences sociales ont montré que la lenteur d’un système peut être un révélateur de sa complexité sous-jacente. Béatrice Collignon, dans ses recherches sur les espaces domestiques, a documenté qu’il lui a fallu entre sept et 8 ans entre ses premières observations et l’idée d’en faire un objet de recherche.
La lenteur n’était pas un défaut méthodologique, mais le signe que l’objet d’étude était plus complexe qu’il n’y paraissait. Pour Muse Spark 1.3, la lenteur des essais via agrégateur d’API pourrait être interprétée de la même manière : ce n’est pas nécessairement un problème d’optimisation, mais le symptôme d’une orchestration multiagent dont les mécanismes internes de coordination sont plus lourds que ce que la documentation laisse entendre.
Les mouvements de terrain lents, comme le retrait-gonflement des argiles, sont sans danger immédiat pour l’homme mais peuvent avoir des conséquences importantes sur les bâtiments. La lenteur de Muse Spark 1.3 dans certains scénarios suit le même schéma : elle ne bloque pas l’utilisateur, mais elle érode la confiance et complique l’intégration dans des workflows où la réactivité est critique.
Une équipe support qui attend 30 secondes de plus par requête perd des heures cumulées chaque semaine.
Pourquoi Muse Spark 1.3 est-il lent dans certains cas ?
La parallélisation multiagent introduit des points de friction : synchronisation entre agents, attente des réponses, gestion des conflits de fusion. Dans certains scénarios, un traitement séquentiel bien optimisé reste plus rapide qu’une orchestration complexe.
Les questions que vous devriez vous poser avant d’investir
Si vous envisagez d’intégrer Muse Spark 1.3 dans un processus professionnel, trois questions méritent une réponse claire avant de vous engager.
Premièrement, quel est le coût réel par tâche accomplie, pas par token ? Les tarifs affichés sont des moyennes. Votre cas d’usage peut consommer beaucoup plus de tokens que prévu, surtout si l’orchestration multiplie les appels d’outils.
Deuxièmement, comment allez-vous auditer ce que fait l’agent ? Sans accès au harnais, vous ne pouvez pas vérifier pourquoi une décision a été prise. Vous voyez le résultat, pas le raisonnement.
Troisièmement, quel est votre plan de sortie ? Si Meta change ses conditions, augmente ses tarifs ou ferme l’accès à certaines fonctionnalités, pouvez-vous migrer vers une alternative sans tout reconstruire ?
Ces questions ne sont pas théoriques. Elles déterminent si un déploiement est viable à long terme ou s’il deviendra un gouffre financier dans 6 mois.
La tarification par paliers, telle qu’elle est documentée dans les guides spécialisés, ajoute une couche de complexité à ces questions. Le choix du palier n’est pas neutre : pour l’ajout de licences supplémentaires, le prix facturé peut être celui du dernier palier atteint, pas du palier initial.
Si le sujet vous intéresse : J’abandonne Framer : mon site passe en Next.js + IA agentique
Vous savez déjà lequel vous correspond ? Accès direct :
Ce que j’attends de la prochaine itération
Trois chantiers détermineront si Muse Spark devient un standard ou reste une démonstration inadaptée aux contraintes européennes.
- L’ouverture de l’API aux développeurs européens, qui conditionnera l’adoption sur le marché francophone
- La publication de benchmarks indépendants sur la latence du mode multiagent
- La clarification des garanties RGPD, sans laquelle les secteurs réglementés resteront à l’écart
Au-delà, il faudra surveiller la tension entre l’écosystème fermé de Meta et les exigences d’interopérabilité qui montent en Europe. Le Digital Markets Act impose déjà des obligations d’ouverture aux grandes plateformes.
Un assistant intégré à WhatsApp, Instagram et Facebook pourrait se retrouver dans le viseur des régulateurs si son intégration verrouille l’écosystème. La prochaine itération devra inclure des mécanismes d’export des données, des API ouvertes pour les concurrents, et des garanties de portabilité.
Si vous testez le modèle, faites-le avec des données fictives, documentez chaque flux, et gardez un plan de sortie. L’IA agentique avance vite, mais en Europe, la conformité reste le juge de paix.
Ce que Meta ne dit pas sur la dépendance structurelle
Il y a un angle que les communications officielles n’abordent jamais frontalement : la dépendance structurelle que crée une intégration poussée dans un écosystème fermé. Les équipes marketing insistent sur la simplicité d’adoption. Personne ne parle du coût de sortie.
Quand vous construisez un service client sur l’API Muse Spark, que vous formez vos équipes à l’orchestration multiagent, et que vous connectez vos bases internes aux connecteurs Meta, vous ne faites pas qu’adopter un outil. Vous scellez une relation de dépendance qui dépasse largement la question du prix.
Une entreprise qui a bâti son workflow sur les connecteurs propriétaires de Meta ne migre pas vers une alternative open source en quelques jours. Elle réingénierie pendant des mois.
Cette réalité n’est pas propre à Meta. Elle vaut pour tous les modèles fermés. Mais elle est plus aiguë ici, parce que l’orchestration multiagent ajoute une couche de complexité supplémentaire.
Vous ne migrez pas seulement un modèle. Vous migrez une architecture de délégation, des profils d’agents, des règles de fusion.
C’est exactement le type de risque que les directions financières devraient intégrer dans leur calcul de coût total de possession. Elles le font rarement.
Quelle est la fenêtre de contexte de Muse Spark 1.3 ?
Muse Spark 1.3 dispose d’une fenêtre de contexte d’un million de tokens et peut générer jusqu’à 132 000 tokens. Cette capacité est pensée pour les longues sessions de raisonnement et les workflows agentiques complexes.
L’angle mort réglementaire que personne ne mesure
Mais la question n’est pas seulement juridique : elle est opérationnelle.
Qui est responsable quand un agent autonome prend une décision erronée ? Le fournisseur du modèle ? L’entreprise qui l’a déployé ? L’utilisateur final qui a validé l’action ?
Les garanties RGPD annoncées par Meta restent floues. Pour les secteurs réglementés (santé, finance, juridique), cette imprécision est rédhibitoire. On ne déploie pas un agent autonome dans un hôpital ou une banque sans savoir exactement où passent les données, qui peut y accéder, et comment prouver la conformité.
C’est une condition d’adoption sur le marché européen. Meta semble l’avoir compris, mais entre l’intention affichée et la mise en œuvre effective, il y a souvent un fossé.
Ce que ça change pour les secteurs réglementés
Pour une banque ou un assureur, la question n’est pas de savoir si l’agent est performant. Elle est de savoir si l’agent est auditable. Or, un modèle fermé dont le harnais d’orchestration n’est pas accessible échoue à ce test élémentaire.
Les directions juridiques exigent des traces, des journaux d’audit, des mécanismes de reprise en main. Tant que Meta ne fournira pas ces garanties de manière contractuelle, les secteurs réglementés resteront à l’écart. C’est un manque à gagner considérable, mais c’est aussi une protection nécessaire.
Muse Spark 1.3 est-il conforme au RGPD ?
La clarification des garanties RGPD reste attendue. Sans engagement contractuel clair sur la localisation des données, les droits d’accès et les mécanismes d’audit, les secteurs réglementés ne peuvent pas intégrer le modèle dans leurs processus.
Mon avis sur Muse Spark 1.3
J’ai vu trop de systèmes informatiques échouer parce que personne n’avait pensé au jour où ça casserait. L’IA agentique ne fera pas exception. La question n’est pas de savoir si Muse Spark 1.3 commettra des erreurs, mais si vous serez en mesure de les détecter, de les prouver et d’obtenir réparation.
Le modèle a des qualités réelles. L’orchestration multiagent est une avancée conceptuelle. La tarification « contributeur » ouvre des perspectives pour les PME.
Mais ces qualités ne compensent pas les zones d’ombre. L’API fermée, la priorité aux profils américains, l’absence de benchmarks indépendants sur la latence, l’imprécision sur les garanties RGPD : tout cela dessine le portrait d’un produit encore en rodage, plus adapté à l’expérimentation qu’au déploiement critique.
Ce que j’attends de la prochaine itération, ce n’est pas plus de puissance. C’est plus de transparence. Un modèle qu’on ne peut pas auditer est un modèle qu’on ne devrait pas déployer dans un processus critique. Point.
| Critère | Muse Spark 1.3 | Ce que ça implique |
|---|---|---|
| Orchestration | Équipe de quatre agents profilés | Délégation de tâches complexes sans pipeline manuel |
| Tarification | Deux paliers dont un « contributeur » | Coûts d’inférence divisés par vingt pour les volumes importants |
| Raisonnement visuel | Environnement d’exécution réel | Moins d’erreurs d’interprétation sur les interfaces graphiques |
| Accès API | Préversion restreinte, priorité aux profils américains | Adoption européenne retardée |
| Fenêtre de contexte | 1 million de tokens | Capacité à traiter de très longues sessions de raisonnement |
Les études qui comptent
| datacamp.com ↗ |
| Muse Spark 1.2: Meta's Next ↗ |
L’orchestration IA vue par un vieux webmestre qui a connu Google pré-Panda
J’ai commencé le blogging en 2009, à une époque où le SEO tenait en trois plugins et une poignée de backlinks achetés à la sauvette.
Depuis, j’ai vu passer les mises à jour Panda, Penguin, Helpful Content, et j’ai surtout vu des centaines d’outils promettre de « révolutionner » la production de contenu avant de finir aux oubliettes.
En 2024, j’ai lancé mon service Maj’Article IA, un pipeline de refonte d’articles qui traite des centaines de pages. Je ne vous parle donc pas d’orchestration IA en théoricien : je sais ce que c’est que d’enchaîner des modèles, de vérifier des sorties, de reprendre la main quand le résultat part en vrille.
Un outil ne remplace jamais le jugement de celui qui a déjà vu des promesses techniques mourir en silence.
Article utile ? Dites-le à Google. Ajoutez ce blog à vos sources préférées : un clic, et vous le retrouverez dans vos recherches (et l’AI Mode) au lieu du contenu recyclé par des robots. C’est votre façon de reprendre le contrôle sur ce que vous lisez.
Et si vous avez aimé, partagez (c’est le meilleur coup de pouce pour un blog indépendant qui publie sans algorithme ni sponsor déguisé).
Un clic, gratuit. Nécessite d’être connecté à votre compte Google.
Ca me va droit au coeur .
Merci Lucie !
Encore un truc d’IA qui va rien changer à ma vie… Franchement ça sent surtout le buzzword marketing à plein nez cette histoire d’agents.
Ah la la, je lis ça entre deux biberons, mon petit a décidé de ne plus dormir cette semaine… Bref. Sinon pour revenir au sujet, ça sent quand même le truc pas fini qu’on va nous vendre comme une révolution. Vivement la suite de vos décryptages.
C’est quoi la différence avec un chatbot normal en fait ? Parce que là j’ai l’impression que c’est juste plusieurs IA qui se parlent entre elles
C’est quoi la différence entre Muse et les autres agents dont on entend parler partout ? Je débute un peu désolé si la question est bête.
Bon. Et concrètement ça change quoi pour nous ? Parce que des agents autonomes on en bouffe depuis 2 ans et j’ai rien vu venir.
Encore une pépite, je suis ce blog depuis des années et vous arrivez toujours à rendre ces trucs de big tech lisibles. Chapeau !!